AHL 4.18a — Critical values and critical regions(臨界値と棄却域)
- critical value(臨界値)と critical region(棄却域)が何かを言える。
- \(p\)-value での判定と critical region での判定が、同じ判定だと説明できる。
- normal distribution(正規分布)の critical value(\(1.645\)、\(1.96\)、\(2.326\)、\(2.576\))を使い分けられる。
- \(z\) の値で表された critical region を、\(\bar{x}\) の値で表し直せる。
- binomial と Poisson で、critical region を自分で作れる。
- 答案に書く丸めた値と、計算に使う丸める前の値を使い分けられる。
- 離散分布では significance level ちょうどにはできない理由を説明できる。
The idea
1. Critical value and critical region(臨界値と棄却域)
hypothesis test(仮説検定)で、\(p\)-value を使うかわりに「この値より外なら reject する」という範囲を先に決めておく方法を学びます。SL 4.11 の \(5\) つのステップはそのままで、変わるのは判定の \(4\) 番目だけです。
AHL 4.18 は \(3\) ページに分かれていて、このページはその土台です。分布ごとの検定は AHL 4.18b、Type I error と Type II error は AHL 4.18c で扱います。
SL 4.11 では、こう進めました。
- データを集める
- \(p\)-value を電卓で出す
- \(p\)-value と significance level を比べる
critical region は、順番を逆にします。
- データを見る前に、「どこから先が出たら reject するか」を決めておく
- データを集める
- その範囲に入っているかどうかだけを見る
この「どこから先」の境目が critical value(臨界値)、境目より外の範囲が critical region(棄却域)です。
テストの合格ラインを、答案を採点する前に「\(60\) 点以上」と決めておくのと同じことです。
先に決めておけば、採点したあとに「この子は \(58\) 点だけど、まあいいか」と揺らぐことがありません。
critical region を先に決めるのも、同じ理由です。データを見てから基準を動かせないようにしています。
2. Same decision as the \(p\)-value(\(p\) 値による判定と同じ判定)
\(2\) つの道具は、どちらか一方を選ぶものではありません。同じことを、別の言い方でやっています。
| \(p\)-value で判定 | critical region で判定 | |
|---|---|---|
| 見るもの | データから出した確率 | データの値そのもの |
| 比べる相手 | significance level \(\alpha\) | critical value |
| reject するのは | \(p < \alpha\) のとき | 値が critical region の中にあるとき |
この \(2\) つは、必ず同じ結論になります。
理由は、どちらも同じ大小関係を見ているからです。
片側の検定で考えます。critical region の外側の裾の面積は \(\alpha\)(離散分布では \(\alpha\) 以下)です。データが critical region の中にあれば、データより外の面積は境目より外の面積より小さくなります。つまり \(p\)-value が \(\alpha\) より小さい、ということです。
両側の検定では、\(p\)-value は片方の裾の面積の \(2\) 倍、\(\alpha\) も \(2\) つの裾に半分ずつ分けたものなので、比べている形は同じです。
Why it worksで、この一致を数値で確かめます。
Find the critical region と書いてあれば critical region、Find the p-value と書いてあれば \(p\)-value です。指定があれば、それに従ってください。
指定がなければ、どちらでも構いません。そのときは、どちらを使ったのかが分かるように書いてください。
そして、時間があればもう一方でも確かめられます。 \(2\) つは必ず同じ結論になるので(Why it works)、食い違ったらどこかで計算を間違えています。
3. One-tailed and two-tailed tests(片側検定と両側検定)
significance level \(\alpha\) は、critical region の面積です。 この面積をどこに置くかが、片側と両側の違いです。
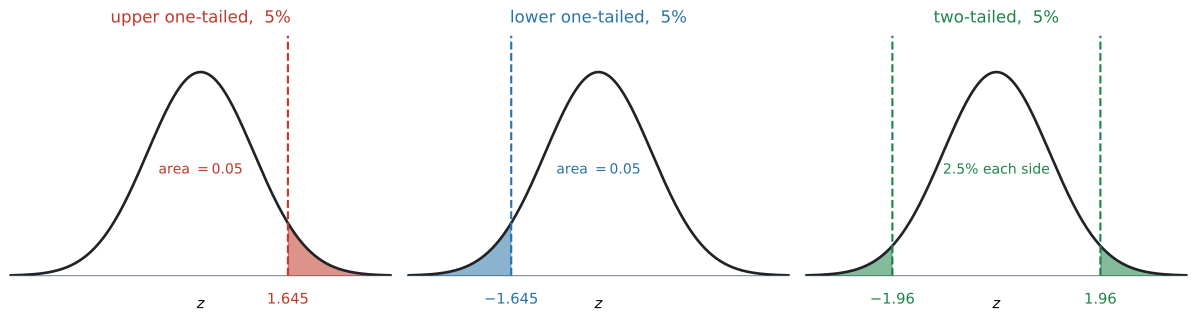
図 1 を見てください。どの \(3\) つも、塗った部分の面積は合わせて \(0.05\) です。
- one-tailed(片側)… \(H_1\) が \(\mu > \mu_0\) か \(\mu < \mu_0\) のとき。\(5\%\) を片方の裾にまとめて置きます。
- two-tailed(両側)… \(H_1\) が \(\mu \neq \mu_0\) のとき。\(5\%\) を半分ずつ、両方の裾に置きます。
両側にすると、片方の裾は \(2.5\%\) しかもらえません。面積が減ると、境目は外へ動きます。
\[ 1.645 \ \longrightarrow \ 1.96 \]
\(H_1\) を読み違えて片側の \(1.645\) を使うと、本当は reject できない値まで reject してしまいます。
\(H_1\) に \(\neq\) があるかどうかを、必ず先に見てください。
4. Critical values for the normal distribution(正規分布の臨界値)
\(\sigma\) が分かっている場合、判定に使う分布は標準正規分布です。critical value は、片方の裾の面積で決まります。
- 片側 \(5\%\) … \(1.645\)
- 両側 \(5\%\) … \(1.96\)(左右に \(2.5\%\) ずつ)
- 片側 \(1\%\) … \(2.326\)
- 両側 \(1\%\) … \(2.576\)(左右に \(0.5\%\) ずつ)
覚えていなくても、GDC 第1節 の Inverse Normal で出せます。 ただし \(1.645\) と \(1.96\) はよく出るので、覚えておくと速くて安全です。
符号は、\(H_1\) の向きで決めます。 上側(\(\mu > \mu_0\))なら \(z > 1.645\)、下側(\(\mu < \mu_0\))なら \(z < -1.645\) です。両側(\(\mu \neq \mu_0\))は \(z < -1.96\) または \(z > 1.96\) の \(2\) つの範囲で、\(1\) つにまとめて書けません。
5. Critical region for \(\bar{x}\)(\(\bar{x}\) で表した棄却域)
ここまで、棄却域を \(z\) の値で表してきました。試験では「critical region を \(\bar{x}\) で答えなさい」と聞かれることがあります。例 1 なら、\(25\) 袋の平均が何グラムより小さければ \(H_0\) を棄却するのか、その境目をグラムで求める、ということです。
まず、やってみます
例 1 の設定で書きかえます。\(\mu_0 = 500\)、\(\sigma = 8\)、\(n = 25\)、有意水準 \(5\%\)、\(H_1\): \(\mu < 500\) の下側検定です。
手順1。\(\dfrac{\sigma}{\sqrt{n}}\) を計算します(この値を standard error(標準誤差)といいます)。
\[ \frac{\sigma}{\sqrt{n}} = \frac{8}{\sqrt{25}} = \frac{8}{5} = 1.6 \]
手順2。\(z\) で表した棄却域を、\(\bar{x}\) で書きかえます。 下側 \(5\%\) の棄却域は \(z < -1.645\) でした(第4節)。\(z\) は \(\dfrac{\bar{x} - \mu_0}{\sigma / \sqrt{n}}\) なので(AHL 4.18b)、これを入れて \(\bar{x}\) について解きます。
\[ \begin{aligned} z &< -1.645 \\[2pt] \frac{\bar{x} - 500}{1.6} &< -1.645 \\[2pt] \bar{x} - 500 &< -1.645 \times 1.6 = -2.632 \\[2pt] \bar{x} &< 500 - 2.632 = 497.368 \end{aligned} \]
これで求まりました。\(z\) で表した条件を、平均の重さで表し直しただけです。新しい検定をしたわけではありません。
\(1\) つ注意です。ここで使った \(-1.645\) は、\(-1.6448536\ldots\) を丸めた値です。ですから境目も厳密には \(497.3682\ldots\) で、このページで \(497.368\ldots\) と書いているのは、この丸める前の境目のことです。小数第1位まで(\(497.4\))で答えるなら、どちらで計算しても同じです。
ここからは、この計算で使った \(3\) つのことを順に説明します。
なぜ \(\dfrac{\sigma}{\sqrt{n}}\) なのか — standard error(標準誤差)
\(\sigma\) と \(\dfrac{\sigma}{\sqrt{n}}\) は、どちらも「ばらつき」ですが、ばらついているものが違います。
- 袋 \(1\) つ \(1\) つの重さがばらつきます。それを表すのが population standard deviation(母標準偏差)\(\sigma\) です。例 1 では \(\sigma = 8\) g です。
- 次に、\(25\) 袋ずつ選んで平均を求めます。選ぶ \(25\) 袋が変われば、平均も変わります。 つまり \(\bar{x}\) も、ばらつく値です。
- この標本平均のばらつきを表す標準偏差が standard error です。独立に \(n\) 個選んだときは \(\dfrac{\sigma}{\sqrt{n}}\) になります(AHL 4.15、AHL 4.16)。
ですから、袋 \(1\) 個の重さの標準偏差は \(8\) g ですが、\(25\) 個の平均の標準誤差は \(1.6\) g。 平均を取ると、ばらつきは \(5\) 分の \(1\) になります。
「誤差」という名前ですが、計算ミスという意味ではありません。 また、手元の \(\bar{x}\) が \(\mu\) から実際にどれだけずれているか、という値でもありません。標本を取り直したときに、\(\bar{x}\) がどれくらい動くかを表す値です。
なぜ中心が \(500\) なのか — \(H_0\) を正しいと仮定しています
\(\bar{X}\) の分布は、平均が \(\mu_0\)、standard deviation が standard error の正規分布です。
\[ \bar{X} \sim N\!\left(\mu_0,\ \frac{\sigma^{2}}{n}\right) \]
中心が \(\mu_0\) になるのは、\(H_0\) が正しいと仮定したときです。本当の \(\mu\) が別の値なら、分布の中心もそこへ動きます(AHL 4.18c)。棄却域は「\(H_0\) が正しいとしたら、めったに起きない範囲」なので、この仮定の上で作ります。
正規分布として扱える条件も、ひとこと。母集団が正規分布なら、\(\bar{X}\) は正確に正規分布です。母集団が正規分布とは限らないときは、\(n\) が大きければ central limit theorem(中心極限定理)によって、近似的に正規分布として扱います(AHL 4.15)。
使った式は、標準化の式の変形です
手順2でやったことを、文字のままやると次のようになります。\(z = \dfrac{\bar{x} - \mu_0}{\sigma / \sqrt{n}}\) の両辺に \(\dfrac{\sigma}{\sqrt{n}}\) をかけて、\(\mu_0\) を移すと
\[ \bar{x}_{\text{crit}} = \mu_0 + z_{\text{crit}} \times \frac{\sigma}{\sqrt{n}} \tag{1}\]
です。この形を覚える必要はありません。標準化の式を変形すると求められます。
\(z_{\text{crit}}\) には、符号を付けたままの critical value を入れます。下側の検定(\(H_1\): \(\mu < \mu_0\))なら、入れるのは負の値です。有意水準 \(5\%\) なら \(z_{\text{crit}} = -1.645\) になります。
上側の検定なら、\(z_{\text{crit}}\) に正の値を入れ、境目は平均より上に \(1\) つできます。両側の検定なら、正と負の両方を入れて、境目を \(2\) つ作ります(第4節)。
\(2\) つの図は、同じ条件を表しています
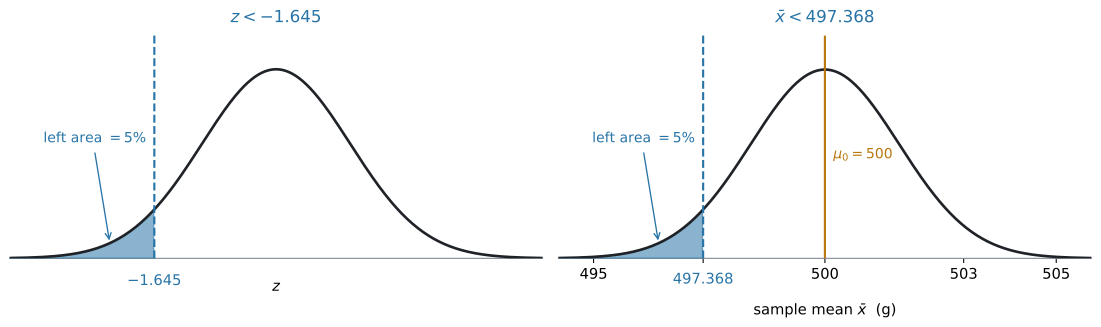
左の図は \(z < -1.645\)、右の図は \(\bar{x} < 497.368\) を塗ったものです。横軸の目盛りは違いますが(\(z\) か、グラム)、表している棄却の条件は同じです。 どちらも、左側の面積が \(5\%\) になっています。
答案では、丸める前の値で判定し、指定の精度で書きます
途中の計算と判定には、丸める前の値を使います。答案には、問題文が指定した精度で書きます。 例 1 なら、判定は \(497.368\ldots\) で行い、答案には \(497.4\)(小数第1位)と書きます。丸め方はふつうに四捨五入で、特別な決まりはありません。
(1)どの場面で、どちらの値を使うのか
| 場面 | 使う値 |
|---|---|
| 答えとして書く | 指定された桁に四捨五入した値(\(497.4\)) |
| 境目に近い観測値を判定する | 丸める前の \(497.368\ldots\) |
| Type II error の確率を計算する(AHL 4.18c) | 丸める前の \(497.368\ldots\) |
電卓に保存しておけば、打ち直さずに使えます(GDC 第2節)。
(2)連続分布では、\(<\) と \(\leq\) の違いは効きません
正規分布では、\(1\) 点ちょうどの確率が \(0\) です。
\[ P(\bar{X} = 497.368\ldots) = 0 \]
ですから \(\bar{x} < c\) と \(\bar{x} \leq c\) は同じ確率で、どちらで書いても構いません。
離散分布は違います。 \(P(X = 15)\) は \(0\) ではないので、境目の整数を含めるかどうかで確率が変わります(第6節)。そこだけは、\(\geq\) と \(>\) を厳密に区別してください。
(3)Type I error の確率が、ちょうど \(\alpha\) になる理由
critical region を丸める前の値で決めているので、正規分布では
\[ P(\text{データが critical region に入る} \mid H_0) = \alpha \]
がぴったり成り立ちます。これが AHL 4.18c の Type I error の確率です。
答案に書いた丸めた値を確率計算に入れ直すと、\(\alpha\) からわずかにずれます。それは「その丸め値が間違い」という意味ではなく、「精密な計算には丸める前の値を使う」という意味です。
例題 1 A machine fills bags of flour. The mass of a bag is normally distributed with standard deviation \(\sigma = 8\) grams. The machine is set to a mean of \(500\) grams.
A quality inspector suspects that the machine is underfilling. She takes a random sample of \(25\) bags and will test at the \(5\%\) significance level.
(a) State the null and alternative hypotheses.
(b) Find the critical region for \(\bar{x}\), giving your value correct to one decimal place.
(c) The sample mean is \(496.5\) grams. State the conclusion of the test, giving a reason.
日本語訳
ある機械が小麦粉を袋詰めしています。袋の重さは standard deviation \(\sigma = 8\) グラムの正規分布にしたがいます。機械は平均 \(500\) グラムに設定されています。
underfill は「規定より少なく詰める」という意味です。
品質検査官は、機械が少なく詰めているのではないかと疑っています。無作為に \(25\) 袋を選び、有意水準 \(5\%\) で検定します。
(a) 帰無仮説と対立仮説を書きなさい。
(b) \(\bar{x}\) の critical region を、値を小数第1位まで求めなさい。
(c) 標本平均は \(496.5\) グラムでした。理由を付けて、検定の結論を述べなさい。
(a) 「少なく詰めている」を疑っているので、\(H_1\) は下側です。\(H_0\) はいつも「変わっていない」ほうです(SL 4.11)。
\[ H_0: \mu = 500, \qquad H_1: \mu < 500 \]
(b) まず standard error を出します。
\[ \frac{\sigma}{\sqrt{n}} = \frac{8}{\sqrt{25}} = \frac{8}{5} = 1.6 \]
片側 \(5\%\) の critical value は \(1.645\) です。\(H_1\) が下側なので、\(z_{\text{crit}} = -1.645\) を入れます(式 1)。
\[ \bar{x}_{\text{crit}} = 500 - 1.645 \times 1.6 = 497.368\ldots \]
小数第1位までと指定されているので、ふつうに四捨五入して \(497.4\) です。
critical region は \(\bar{x} < 497.4\) です。
検算。 \(497.4\) は \(500\) より小さくなっています ✓ 下側の検定なので、境目は平均より下にあるはずです。
(c) \(496.5\) は \(497.368\ldots\) より小さいので、観測値は critical region の中にあります。境目に近くないので、丸めた \(497.4\) と比べても同じ結論です(第5節)。
試験ではこう書く
The sample mean \(496.5\) g lies in the critical region \(\bar{x} < 497.4\) g, so we reject \(H_0\) at the \(5\%\) significance level.
There is sufficient evidence to suggest that the machine is underfilling the bags.
(sample(標本)平均 \(496.5\) g は critical region \(\bar{x} < 497.4\) g の中にあるので \(5\%\) 水準で \(H_0\) を棄却する、機械が少なく詰めていることを示す十分な証拠がある、という意味です。)
accept とは書きません
\(H_0\) を reject する、と書きます。\(H_1\) を「正しいと証明した」わけではありません(SL 4.11)。
そして、必ず文脈のことばに戻してください。 「\(H_0\) を棄却する」だけで止めると、点が付かないことがあります。
(a) \[ H_0: \mu = 500, \qquad H_1: \mu < 500 \]
(b) \[ \frac{\sigma}{\sqrt{n}} = \frac{8}{\sqrt{25}} = 1.6 \] \[ \bar{x}_{\text{crit}} = 500 - 1.645 \times 1.6 = 497.368\ldots = 497.4 \ \text{(1 d.p.)} \] Critical region: \(\bar{x} < 497.4\) g.
(c) \(496.5 < 497.4\), so the sample mean is in the critical region. Reject \(H_0\) at the \(5\%\) level: there is evidence that the machine is underfilling.
例題 2 The contents of a bottle of juice are normally distributed with standard deviation \(\sigma = 1.5\) ml. The label claims a mean of \(20\) ml.
A consumer group tests, at the \(5\%\) significance level, whether the mean has changed. A random sample of \(36\) bottles is taken.
(a) Write down the alternative hypothesis.
(b) Find the critical region for \(\bar{x}\), giving your values correct to three significant figures.
(c) The sample mean is \(20.55\) ml. State, with a reason, whether the label should be questioned.
日本語訳
あるジュースの内容量は standard deviation \(\sigma = 1.5\) ml の正規分布にしたがいます。ラベルには平均 \(20\) ml と書かれています。
consumer group は「消費者団体」という意味です。
消費者団体は、平均が変わったかどうかを有意水準 \(5\%\) で検定します。無作為に \(36\) 本を選びます。
(a) 対立仮説を書きなさい。
(b) \(\bar{x}\) の critical region を、有効数字3桁で求めなさい。
(c) 標本平均は \(20.55\) ml でした。ラベルを疑うべきかどうかを、理由を付けて述べなさい。
(a) 「変わったかどうか」なので、どちらの向きも指定していません。両側です。
\[ H_1: \mu \neq 20 \]
(b) standard error は
\[ \frac{\sigma}{\sqrt{n}} = \frac{1.5}{\sqrt{36}} = \frac{1.5}{6} = 0.25 \]
両側 \(5\%\) なので \(z_{\text{crit}} = 1.96\) です(\(1.645\) ではありません)。
\[ 20 \pm 1.96 \times 0.25 = 20 \pm 0.49 \]
正確には \(19.510\ldots\) と \(20.489\ldots\) です。有効数字3桁と指定されているので、ふつうに四捨五入します。
\[ \bar{x} < 19.5 \quad \text{または} \quad \bar{x} > 20.5 \]
検算。 \(2\) つの境目は \(20\) から同じだけ離れています ✓ 両側検定では、境目は必ず \(\mu_0\) について対称です。
(c) \(20.55 > 20.5\) なので、critical region の中です。
試験ではこう書く
The sample mean \(20.55\) ml lies in the critical region \(\bar{x} > 20.5\) ml, so we reject \(H_0\) at the \(5\%\) significance level.
There is sufficient evidence that the mean contents differ from the \(20\) ml stated on the label, so the label should be questioned.
(標本平均 \(20.55\) ml は critical region \(\bar{x} > 20.5\) ml の中にあるので \(5\%\) 水準で \(H_0\) を棄却する、平均がラベルの \(20\) ml と異なるという十分な証拠があるのでラベルは疑うべきだ、という意味です。)
片側の \(1.645\) を使ってしまうと、境目は \(20 + 1.645 \times 0.25 = 20.411\ldots\) になります。
この問題では、どちらを使っても「reject」という結論は変わりません。しかし \(\bar{x} = 20.45\) だったら、結論が分かれます。 \(1.96\) なら reject しませんが、\(1.645\) なら reject してしまいます。
「答えが同じだったから、まあいいか」では済みません。
(a) \[ H_1: \mu \neq 20 \]
(b) \[ \frac{\sigma}{\sqrt{n}} = \frac{1.5}{\sqrt{36}} = 0.25 \] \[ 20 \pm 1.96 \times 0.25 = 20 \pm 0.49 \] Critical region: \(\bar{x} < 19.5\) or \(\bar{x} > 20.5\).
(c) \(20.55 > 20.5\), so the sample mean is in the critical region. Reject \(H_0\) at the \(5\%\) level: there is evidence that the mean differs from \(20\) ml, so the label should be questioned.
6. Discrete distributions(二項分布とポアソン分布の棄却域)
binomial と Poisson でも critical region を作れますが、確率をちょうど \(\alpha\) にはできません。ここが、この項目でいちばん間違えやすいところです。 なお、binomial と Poisson で critical region を求めるのは片側検定だけです。両側は出ません。
正規分布は連続なので、面積をちょうど \(0.05\) に切れます。binomial と Poisson は、値が整数しかありません。
\(X \sim B(25,\ 0.4)\) を例にとると、\(14\) と \(15\) のあいだに \(X\) が取れる値はありません。ですから、境目を少しずつ動かして確率を \(0.05\) に合わせる、ということができません。
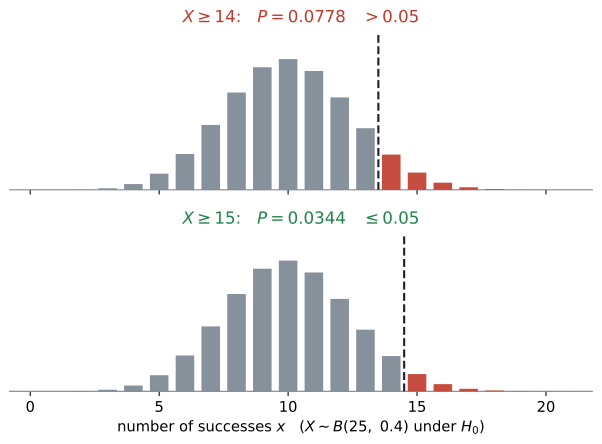
図 3 が、その様子です。\(X \geq 14\) は確率 \(0.0778\) で \(5\%\) を超えてしまい、\(X \geq 15\) は \(0.0344\) で \(5\%\) に届きません。ちょうど \(0.05\) になる境目は、ありません。
では、どちらを選ぶか。この例では \(X \geq 15\) です。 \(0.05\) を超えないほうを選びます。
決まりはこうです。確率が \(\alpha\) を超えない範囲で、いちばん大きい region を選びます。(ここでの確率は、\(H_0\) が正しいのに reject してしまう Type I error の確率です。)\(5\%\) の上側検定なら
\[ P(X \geq k) \leq 0.05 \ \text{となる} \ \textbf{最小の} \ k \tag{2}\]
を探します。\(k\) が小さいほど region は大きいので、「\(\alpha\) 以下でいちばん大きい」は「条件を満たす最小の \(k\)」と同じことです。下側なら \(P(X \leq k) \leq \alpha\) となる最大の \(k\) です。
- \(X \geq 14\)(\(0.0778\))… \(0.05\) を超えるので使えません。「\(0.05\) に近いから」では選びません。近さではなく、超えないかどうかです。
- \(X \geq 16\)(\(0.0132\))… 超えてはいませんが、必要以上に小さい region です。小さくすると、\(H_0\) が間違っているときに気づきにくくなります(AHL 4.18c の Type II error です)。
例題 3 In the past, \(40\%\) of customers at a café have chosen the vegetarian option. The owner introduces a new vegetarian dish and believes that the proportion has increased.
She records the choices of a random sample of \(25\) customers. Let \(X\) be the number who choose the vegetarian option, and test at the \(5\%\) significance level.
(a) State the hypotheses in terms of \(p\).
(b) Find the critical region for \(X\).
(c) Find the probability that \(X\) lies in the critical region when \(H_0\) is true.
日本語訳
これまで、あるカフェの客の \(40\%\) がベジタリアン向けのメニューを選んでいました。店主は新しいベジタリアン料理を出し、その割合が増えたと考えています。
vegetarian option は「ベジタリアン向けの選択肢」という意味です。
無作為に選んだ \(25\) 人の客の選択を記録します。\(X\) をベジタリアン向けを選んだ人数として、有意水準 \(5\%\) で検定します。
(a) \(p\) を使って仮説を書きなさい。
(b) \(X\) の critical region を求めなさい。
(c) \(H_0\) が正しいとき、\(X\) が critical region に入る確率を求めなさい。
(a) 「増えた」を疑っているので上側です。
\[ H_0: p = 0.4, \qquad H_1: p > 0.4 \]
(b) \(H_0\) が正しいとすると \(X \sim B(25,\ 0.4)\) です。\(P(X \geq k) \leq 0.05\) となる最小の \(k\) を探します(式 2)。
電卓で、上から順に試します。
| \(k\) | \(P(X \geq k)\) | \(0.05\) 以下か |
|---|---|---|
| \(14\) | \(0.0778\) | いいえ |
| \(15\) | \(\mathbf{0.0344}\) | はい |
\(k = 14\) では \(5\%\) を超えてしまいます。\(k = 15\) で初めて \(5\%\) 以下になります。
critical region は \(X \geq 15\) です。
検算。 \(H_0\) のもとでの平均は \(25 \times 0.4 = 10\) です ✓ 上側の検定なので、critical region が平均より上にあるのは正しい向きです。
(c) (b) で出した値がそのまま答えです。
\[ P(X \geq 15) = 0.0344 \]
(a) \[ H_0: p = 0.4, \qquad H_1: p > 0.4 \]
(b) Under \(H_0\), \(X \sim B(25,\ 0.4)\). \[ P(X \geq 14) = 0.0778 > 0.05 \] \[ P(X \geq 15) = 0.0344 < 0.05 \] Critical region: \(X \geq 15\).
(c) \[ P(X \geq 15) = 0.0344 \]
例題 4 A shop receives complaints at a mean rate of \(6\) per week, following a Poisson distribution. After a change of supplier, the manager wishes to test whether the rate of complaints has increased.
Let \(X\) be the number of complaints in one week, and test at the \(5\%\) significance level.
(a) Find the critical region for \(X\).
(b) In the week after the change, \(9\) complaints are received. State the conclusion of the test.
(c) Explain why the critical region \(X \geq 12\) would not be used, even though its probability is less than \(0.05\).
日本語訳
ある店には \(1\) 週あたり平均 \(6\) 件の割合で苦情が届き、ポアソン分布にしたがいます。仕入先を変えたあと、店長は苦情の割合が増えたかどうかを検定したいと考えています。
complaint は「苦情」、supplier は「仕入先」という意味です。
\(X\) を \(1\) 週間の苦情の件数として、有意水準 \(5\%\) で検定します。
(a) \(X\) の critical region を求めなさい。
(b) 変更後の週には \(9\) 件の苦情が届きました。検定の結論を述べなさい。
(c) critical region を \(X \geq 12\) としない理由を、その確率が \(0.05\) より小さいにもかかわらず、と説明しなさい。
(a) \(H_0\): \(m = 6\)、\(H_1\): \(m > 6\) です。\(H_0\) のもとで \(X \sim \mathrm{Po}(6)\)(AHL 4.17)。
| \(k\) | \(P(X \geq k)\) | \(0.05\) 以下か |
|---|---|---|
| \(10\) | \(0.0839\) | いいえ |
| \(11\) | \(\mathbf{0.0426}\) | はい |
critical region は \(X \geq 11\) です。
検算。 \(H_0\) のもとでの平均は \(6\) です ✓ 上側の検定なので、\(11\) が \(6\) より上にあるのは正しい向きです。
(b) \(9 < 11\) なので、critical region の外です。
試験ではこう書く
\(9\) is not in the critical region \(X \geq 11\), so we do not reject \(H_0\) at the \(5\%\) significance level.
There is insufficient evidence to suggest that the rate of complaints has increased.
(\(9\) は critical region \(X \geq 11\) に入っていないので \(5\%\) 水準で \(H_0\) を棄却しない、苦情の割合が増えたと言うだけの証拠はない、という意味です。)
(c) \(P(X \geq 12) = 0.0201\) で、たしかに \(0.05\) より小さくなっています。しかし、もっと大きい region が \(0.05\) 以下で取れます。
試験ではこう書く
The critical region must be as large as possible while its probability stays at or below the significance level.
Since \(P(X \geq 11) = 0.0426\) is still less than \(0.05\), the region \(X \geq 11\) is larger than \(X \geq 12\) and is still allowed, so \(X \geq 12\) is not used.
(critical region は、その確率が significance level(有意水準)以下にとどまる範囲で、できるだけ大きく取らなければならない。\(P(X \geq 11) = 0.0426\) はまだ \(0.05\) より小さく、\(X \geq 11\) のほうが \(X \geq 12\) より大きくてなお許されるので、\(X \geq 12\) は使わない、という意味です。)
do not reject であって、accept ではありません
- で \(H_0\) を棄却しませんでした。これは「苦情は増えていないと分かった」という意味ではありません。
「増えたと言えるだけの証拠がなかった」というだけです(SL 4.11)。
英語では do not reject \(H_0\) または there is insufficient evidence と書きます。
(a) Under \(H_0\), \(X \sim \mathrm{Po}(6)\). \[ P(X \geq 10) = 0.0839 > 0.05 \] \[ P(X \geq 11) = 0.0426 < 0.05 \] Critical region: \(X \geq 11\).
(b) \(9\) is not in the critical region, so do not reject \(H_0\) at the \(5\%\) level. There is insufficient evidence that the rate of complaints has increased.
(c) \(P(X \geq 11) = 0.0426 < 0.05\), so \(X \geq 11\) is allowed and is a larger region than \(X \geq 12\). The critical region must be the largest region whose probability does not exceed the significance level.
7. No critical regions for \(t\)-tests(\(t\) 検定では棄却域を求めない)
\(t\) 検定では、critical region を求めなくてよいことになっています。\(t\) 分布の critical value は degrees of freedom(自由度)によって変わり、\(n = 10\) と \(n = 30\) では別の数になるからです。\(\sigma\) が分からない場合(\(t\) を使う場合)は、\(p\)-value で判定してください(AHL 4.18b)。
| 場面 | critical region | 判定 |
|---|---|---|
| \(\sigma\) 既知(normal) | 求める | どちらでもよい |
| \(\sigma\) 未知(\(t\)) | 求めない | \(p\)-value で |
| binomial・Poisson | 求める(片側のみ) | どちらでもよい |
Why it works
\(2\) つの判定が一致する理由
第2節で「\(p\)-value での判定と critical region での判定は同じ結論になる」と書きました。数値で確かめます。
例 1 の設定を使います。\(\mu_0 = 500\)、\(\sigma = 8\)、\(n = 25\)、\(H_1\): \(\mu < 500\)、\(5\%\)。critical value は \(497.368\ldots\)(答案には \(497.4\))でした。ここでは丸める前の値で比べます。
| 観測値 \(\bar{x}\) | critical region の中か | \(p\)-value | \(p < 0.05\) か |
|---|---|---|---|
| \(496.5\) | 中(\(496.5 < 497.368\)) | \(0.0144\) | はい |
| \(497.5\) | 外(\(497.5 > 497.368\)) | \(0.0591\) | いいえ |
\(2\) 行とも、左右の答えが一致しています。
なぜそうなるか。片側の検定で考えます。\(p\)-value は「観測値より外の面積」、critical region の面積は \(\alpha\) です。
観測値が critical region の中にあるということは、観測値が境目より外にあるということです。すると「観測値より外の面積」は「境目より外の面積」より小さくなります。つまり \(p < \alpha\) です。
両側でも、\(2\) 倍どうしを比べるので同じことになります。
逆も同じです。\(2\) つは、同じ大小関係を、面積で見るか位置で見るかの違いで表しているだけです。
では、なぜ \(2\) つとも学ぶのか
問われ方が違うからです。
Find the critical region… 範囲そのものを聞かれています。\(p\)-value では答えられません。Find the p-value… 確率を聞かれています。範囲では答えられません。Test at the 5% level… どちらでも構いません。
そして AHL 4.18c の Type I / Type II error は、critical region がないと計算できません。 critical region は、そのための道具でもあります。
Common errors
\(H_1\) に \(\neq\) があったら \(1.96\) です。\(5\%\) が半分ずつに分かれるので、境目は外へ動きます(第3節)。
\(H_1\): \(\mu < \mu_0\) なら \(z_{\text{crit}} = -1.645\) です。表の数は正のままなので、自分で符号を決めます(第4節)。
at least と more than を取り違える
\(P(X \geq 11)\) と \(P(X > 11)\) は違います。後者は \(P(X \geq 12)\) です(AHL 4.17)。
critical region を書くときも、\(\geq\) か \(>\) かをはっきりさせてください。
\(t\) 検定の critical region は求めなくてよいことになっています(第7節)。\(\sigma\) が分からないときは、\(p\)-value で判定してください。
Find the critical region に対して \(497.4\) とだけ書くと、範囲になっていません。
\(\bar{x} < 497.4\) のように、不等号を付けて範囲で答えます。
\(19.5 < \bar{x} < 20.5\) と書くと、critical region ではなく、その反対の範囲になってしまいます。
\(\bar{x} < 19.5\) または \(\bar{x} > 20.5\) です(第4節)。
Using your GDC (TI-Nspire CX II)
1. Critical values from Inverse Normal(正規分布の臨界値を出す)
\(4\) つの数(\(1.645\)、\(1.96\)、\(2.326\)、\(2.576\))は覚えておくのが速いのですが、電卓でも出せます。
menu → Statistics → Distributions → Inverse NormalInverse Normal で critical value
| 欄 | 入れるもの |
|---|---|
Area |
境目より左の面積 |
μ |
\(0\) |
σ |
\(1\) |
Area は「左の面積」です
Inverse Normal は、左からの面積を受け取ります。上側 \(5\%\) の境目がほしいなら、入れるのは \(0.05\) ではなく \(0.95\) です。
Area に何を入れるか
| ほしいもの | Area に入れる数 |
出てくる値 |
|---|---|---|
| 上側 \(5\%\) の境目 | \(0.95\) | \(1.645\) |
| 下側 \(5\%\) の境目 | \(0.05\) | \(-1.645\) |
| 両側 \(5\%\) の上の境目 | \(0.975\) | \(1.96\) |
| 両側 \(5\%\) の下の境目 | \(0.025\) | \(-1.96\) |
両側は \(\alpha\) を \(2\) で割ってから考えてください。
2. Critical value for \(\bar{x}\)(\(\bar{x}\) の臨界値を直接出す)
μ と σ に \(0\) と \(1\) ではなく、\(\mu_0\) と standard error を入れると、\(\bar{x}\) の境目がそのまま出ます。
例 1 なら、こうです。
Inverse Normal: Area: 0.05 μ: 500 σ: 1.6\[ 497.368\ldots \]
\(z\) を経由しなくても出せます。ただし、答案には 式 1 の \(1\) 行を書いてください。 電卓から読んだ数だけでは、過程に点が付きません。
3. Discrete critical regions(二項分布・ポアソン分布の棄却域を探す)
Binomial Cdf と Poisson Cdf を、\(k\) を変えながら何回か使います。
menu → Statistics → Distributions → Binomial Cdf
                                  → Poisson Cdf
例 3 なら、\(P(X \geq 14)\) は「\(14\) から \(25\) まで」です。
Binomial Cdf:   Num Trials, n: 25    Prob Success, p: 0.4
Lower Bound: 14 Upper Bound: 25Poisson Cdf の Upper Bound には、\(m\) よりずっと大きい数を入れてください。例 4 なら \(100\) で十分です。
\(\mathrm{Po}(6)\) で \(X\) が \(100\) を超える確率は、\(0\) と区別できないほど小さいからです。
Inverse Binomial を使うと、\(1\) 回で探せます
Binomial Cdf を何回も打つかわりに、こう使えます。
menu → Statistics → Distributions → Inverse BinomialCumulative Prob に \(0.95\)、Num Trials, n に \(25\)、Prob Success, p に \(0.4\) を入れると、\(P(X \leq k) \geq 0.95\) となる最小の \(k\) が出ます。
例 3 では \(14\) が出ます。critical region は、その \(1\) つ上からなので \(X \geq 15\) です。
これが使えるのは、上側の検定だけです。 下側(\(H_1\) が \(<\))では、Cumulative Prob に \(\alpha\) を入れて出た \(k\) の\(1\) つ下が境目になります。向きを取り違えると \(2\) つずれるので、下側では Binomial Cdf を繰り返すほうが安全です。
上側でも \(1\) ずれるので、必ず Binomial Cdf で確かめてください。 \(P(X \geq 15) = 0.0344 \leq 0.05\)、\(P(X \geq 14) = 0.0778 > 0.05\)——この \(2\) 行を答案に書けば、\(k\) の選び方まで示せます。
Poisson には対応するコマンドがありません。Poisson Cdf を繰り返してください。
Stat Tests には、binomial 検定も Poisson 検定もありません
menu → Statistics → Stat Testsを開くと z Test、t Test、1-Prop z Test、χ² GOF、Linear Reg t Test などが並んでいます。binomial 検定と Poisson 検定は、この一覧にありません。
この \(2\) つだけは、Binomial Cdf / Poisson Cdf で自分で確率を作ります。
なお 1-Prop z Test は名前が近いので選びたくなりますが、これは正規分布で近似する検定です。このページで使うのは binomial distribution そのものを使う検定なので、別のものです(AHL 4.18b)。
Exercises
1 State the critical value of \(z\) for each of the following tests.
(a) A one-tailed test at the \(5\%\) significance level, with \(H_1: \mu > \mu_0\).
(b) A two-tailed test at the \(5\%\) significance level.
(c) A one-tailed test at the \(1\%\) significance level, with \(H_1: \mu < \mu_0\).
(d) A two-tailed test at the \(1\%\) significance level.
日本語訳
次のそれぞれの検定について、\(z\) の critical value を述べなさい。
(a) \(H_1: \mu > \mu_0\) の、有意水準 \(5\%\) の片側検定。
(b) 有意水準 \(5\%\) の両側検定。
(c) \(H_1: \mu < \mu_0\) の、有意水準 \(1\%\) の片側検定。
(d) 有意水準 \(1\%\) の両側検定。
(a) \(z = 1.645\)
(b) \(z = \pm 1.96\)
(c) \(z = -2.326\)
(d) \(z = \pm 2.576\)
符号は \(H_1\) の向きで決めます(第4節)。
(a) \(H_1\) が上側なので、正の値だけです。
(b) 両側なので \(2\) つ。\(5\%\) が半分ずつになるので \(1.645\) ではなく \(1.96\) です。
(c) \(H_1\) が下側なのでマイナスです。表の \(2.326\) にマイナスを付けます。
(d) 両側 \(1\%\) なので、片方の裾は \(0.5\%\)。\(2.576\) です。
検算。 両側の値は、いつも片側の値より外側にあります ✓ \(1.96 > 1.645\)、\(2.576 > 2.326\)。
2 The lifetime of a type of battery is normally distributed with standard deviation \(\sigma = 12\) hours. The manufacturer claims a mean lifetime of \(250\) hours. A researcher believes the mean is greater than this, and tests at the \(5\%\) significance level using a random sample of \(36\) batteries.
(a) Find the critical region for \(\bar{x}\), giving your value correct to one decimal place.
(b) The sample mean is \(254\) hours. State the conclusion of the test.
日本語訳
ある種類の電池の寿命は standard deviation \(\sigma = 12\) 時間の正規分布にしたがいます。製造元は平均寿命 \(250\) 時間と主張しています。ある研究者は平均がこれより大きいと考え、無作為に選んだ \(36\) 個の電池を使って有意水準 \(5\%\) で検定します。
lifetime は「寿命」、manufacturer は「製造元」という意味です。
(a) \(\bar{x}\) の critical region を、値を小数第1位まで求めなさい。
(b) 標本平均は \(254\) 時間でした。検定の結論を述べなさい。
(a) \[ H_0: \mu = 250, \qquad H_1: \mu > 250 \] \[ \frac{\sigma}{\sqrt{n}} = \frac{12}{\sqrt{36}} = 2 \] \[ \bar{x}_{\text{crit}} = 250 + 1.645 \times 2 = 253.289\ldots = 253.3 \ \text{(1 d.p.)} \] Critical region: \(\bar{x} > 253.3\) hours.
(b) \(254 > 253.3\), so the sample mean is in the critical region. Reject \(H_0\) at the \(5\%\) level: there is evidence that the mean lifetime is greater than \(250\) hours.
(a) 「より大きい」なので上側の片側検定です。\(z_{\text{crit}} = 1.645\)、符号は \(+\) です。
standard error は \(\dfrac{12}{\sqrt{36}} = \dfrac{12}{6} = 2\)。\(\sqrt{n}\) を忘れないでください。
\[ 250 + 1.645 \times 2 = 253.289\ldots \]
小数第1位までと指定されているので、ふつうに四捨五入して \(253.3\) です。
検算。 境目が \(250\) より上にあります ✓ 上側の検定なので、正しい向きです。
(b) \(254\) は \(253.289\ldots\) より大きいので、critical region の中です。境目から離れているので、丸めた \(253.3\) と比べても同じ結論になります。
\(p\)-value で確かめても、同じ結論になります。\(P(\bar{X} > 254) = 0.0228 < 0.05\) です(Why it works)。
結論は、必ず文脈のことばに戻してください。 「\(H_0\) を棄却する」で止めないでください。
3 The diameter of a machine part is normally distributed with standard deviation \(\sigma = 0.2\) mm. The target diameter is \(1.5\) mm. An engineer tests, at the \(1\%\) significance level, whether the mean diameter has changed. A random sample of \(25\) parts is measured.
(a) Find the critical region for \(\bar{x}\), giving your values correct to two decimal places.
(b) The sample mean is \(1.62\) mm. State the conclusion of the test.
日本語訳
ある機械部品の直径は standard deviation \(\sigma = 0.2\) mm の正規分布にしたがいます。目標の直径は \(1.5\) mm です。技術者は、平均の直径が変わったかどうかを有意水準 \(1\%\) で検定します。無作為に \(25\) 個の部品を測ります。
diameter は「直径」、engineer は「技術者」という意味です。
(a) \(\bar{x}\) の critical region を、値を小数第2位まで求めなさい。
(b) 標本平均は \(1.62\) mm でした。検定の結論を述べなさい。
(a) \[ H_0: \mu = 1.5, \qquad H_1: \mu \neq 1.5 \] \[ \frac{\sigma}{\sqrt{n}} = \frac{0.2}{\sqrt{25}} = 0.04 \] \[ 1.5 \pm 2.576 \times 0.04 \ \Rightarrow \ 1.39696\ldots \ \text{and} \ 1.60304\ldots \] Critical region: \(\bar{x} < 1.40\) mm or \(\bar{x} > 1.60\) mm (2 d.p.).
(b) \(1.62 > 1.60\), so the sample mean is in the critical region. Reject \(H_0\) at the \(1\%\) level: there is evidence that the mean diameter has changed.
(a) 「変わったかどうか」なので両側、しかも \(1\%\) です。使うのは \(2.576\) です。
\(4\) つの数のどれを使うかを、\(2\) 段階で決めます。まず \(1\%\) か \(5\%\) か、次に片側か両側か。両方そろって \(1\) つに決まります。
standard error は \(\dfrac{0.2}{5} = 0.04\)。
\[ 2.576 \times 0.04 = 0.10304 \] \[ 1.5 - 0.10304 = 1.39696\ldots, \qquad 1.5 + 0.10304 = 1.60304\ldots \]
小数第2位までと指定されているので、ふつうに四捨五入して \(1.40\) と \(1.60\) です。
検算。 \(2\) つの境目は \(1.5\) から同じだけ離れています ✓
(b) \(1.62\) は \(1.60304\ldots\) より大きいので、critical region の中です。境目に近い値なら、丸める前の \(1.60304\ldots\) と比べてください(第5節)。
「または」でつないだ範囲なので、どちらか一方に入っていれば reject です。
4 A seed company claims that \(25\%\) of its seeds produce red flowers. A gardener suspects the proportion is higher. She plants a random sample of \(30\) seeds and will test at the \(5\%\) significance level.
(a) State the hypotheses in terms of \(p\).
(b) Find the critical region for the number of red flowers, \(X\).
日本語訳
ある種苗会社は、自社の種の \(25\%\) が赤い花をつけると主張しています。ある庭師は、その割合はもっと高いのではないかと考えています。無作為に選んだ \(30\) 粒を植え、有意水準 \(5\%\) で検定します。
seed は「種」、gardener は「庭師」という意味です。
(a) \(p\) を使って仮説を書きなさい。
(b) 赤い花の数 \(X\) の critical region を求めなさい。
(a) \[ H_0: p = 0.25, \qquad H_1: p > 0.25 \]
(b) Under \(H_0\), \(X \sim B(30,\ 0.25)\). \[ P(X \geq 12) = 0.0507 > 0.05 \] \[ P(X \geq 13) = 0.0216 < 0.05 \] Critical region: \(X \geq 13\).
この問題は、境目がとても際どいところにあります。
\[ P(X \geq 12) = 0.0507 \]
\(0.05\) を、わずか \(0.0007\) だけ超えています。 これでは使えません(第6節)。
\[ P(X \geq 13) = 0.0216 \]
こちらは \(0.05\) 以下なので、使えます。critical region は \(X \geq 13\) です。
\(P(X \geq 12)\) を \(3\) 桁に丸めると \(0.0507\) ですが、さらに \(0.05\) に丸めてしまうと「ちょうど \(5\%\) だから使える」と判断してしまいます。
電卓の画面の値を、そのまま \(0.05\) と比べてください。
検算。 \(H_0\) のもとでの平均は \(30 \times 0.25 = 7.5\) です ✓ critical region が \(7.5\) より上にあるのは、上側の検定として正しい向きです。
5 Faults occur in a length of cable at a mean rate of \(4\) per kilometre, following a Poisson distribution. After a change in the manufacturing process, an inspector wishes to test whether the rate of faults has increased. Let \(X\) be the number of faults in one kilometre.
Find the critical region for \(X\) for a test at the \(1\%\) significance level.
日本語訳
あるケーブルには \(1\) km あたり平均 \(4\) 個の割合で欠陥があり、ポアソン分布にしたがいます。製造工程を変えたあと、検査官は欠陥の割合が増えたかどうかを検定したいと考えています。\(X\) を \(1\) km あたりの欠陥の数とします。
fault は「欠陥」、cable は「ケーブル」、manufacturing process は「製造工程」という意味です。
有意水準 \(1\%\) の検定について、\(X\) の critical region を求めなさい。
\[ H_0: m = 4, \qquad H_1: m > 4 \]
Under \(H_0\), \(X \sim \mathrm{Po}(4)\). \[ P(X \geq 9) = 0.0214 > 0.01 \] \[ P(X \geq 10) = 0.00813 < 0.01 \] Critical region: \(X \geq 10\).
\(1\%\) の検定です。 \(5\%\) と混同しないでください。比べる相手は \(0.01\) です。
\[ P(X \geq 9) = 0.0214 \]
\(0.01\) を超えているので使えません。
\[ P(X \geq 10) = 0.00813 \]
\(0.01\) 以下なので使えます。
水準を厳しくすると、critical region は小さくなります。 同じ \(\mathrm{Po}(4)\) でも、\(5\%\) なら \(X \geq 9\)(\(P = 0.0214\))ですが、\(1\%\) では \(X \geq 10\) まで動きました。
検算。 \(H_0\) のもとでの平均は \(4\) です ✓ \(10\) は \(4\) よりずっと上で、上側の検定として正しい向きです。
6 A wildlife camera records animals passing at a mean rate of \(10\) per night, following a Poisson distribution. A researcher believes that recent building work has reduced the rate. Let \(X\) be the number of animals recorded in one night.
Find the critical region for \(X\) for a test at the \(5\%\) significance level.
日本語訳
ある野生動物用のカメラは、\(1\) 晩あたり平均 \(10\) 頭の割合で通りかかる動物を記録し、ポアソン分布にしたがいます。ある研究者は、最近の工事によってその割合が減ったと考えています。\(X\) を \(1\) 晩に記録される動物の数とします。
wildlife camera は「野生動物観察用カメラ」、building work は「工事」という意味です。
有意水準 \(5\%\) の検定について、\(X\) の critical region を求めなさい。
\[ H_0: m = 10, \qquad H_1: m < 10 \]
Under \(H_0\), \(X \sim \mathrm{Po}(10)\). \[ P(X \leq 5) = 0.0671 > 0.05 \] \[ P(X \leq 4) = 0.0293 < 0.05 \] Critical region: \(X \leq 4\).
これは下側の検定です。 「減った」を疑っているので \(H_1\): \(m < 10\) です。
下側では、探し方が逆になります。
\[ P(X \leq k) \leq 0.05 \ \text{となる} \ \textbf{最大の} \ k \]
\(k\) が大きいほど region は大きいので、下側では「最大の \(k\)」を探します(第6節)。
\[ P(X \leq 5) = 0.0671 \quad (\text{超えている}) \] \[ P(X \leq 4) = 0.0293 \quad (\text{使える}) \]
critical region は \(X \leq 4\) です。
検算。 \(H_0\) のもとでの平均は \(10\) です ✓ 下側の検定なので、critical region が平均より下にあるのは正しい向きです。
7 A politician claims that \(60\%\) of voters in a town support a new park. A local newspaper believes the true proportion is lower and surveys a random sample of \(20\) voters. Let \(X\) be the number who support the park.
Find the critical region for \(X\) for a test at the \(5\%\) significance level.
日本語訳
ある政治家は、町の有権者の \(60\%\) が新しい公園に賛成していると主張しています。地元の新聞社は、実際の割合はもっと低いと考え、無作為に選んだ \(20\) 人の有権者に調査します。\(X\) を公園に賛成する人数とします。
politician は「政治家」、voter は「有権者」、survey は「調査する」という意味です。
有意水準 \(5\%\) の検定について、\(X\) の critical region を求めなさい。
\[ H_0: p = 0.6, \qquad H_1: p < 0.6 \]
Under \(H_0\), \(X \sim B(20,\ 0.6)\). \[ P(X \leq 8) = 0.0565 > 0.05 \] \[ P(X \leq 7) = 0.0210 < 0.05 \] Critical region: \(X \leq 7\).
binomial の下側です。\(H_1\): \(p < 0.6\) なので、小さいほうが証拠になります。
\[ P(X \leq 8) = 0.0565 \quad (\text{超えている}) \] \[ P(X \leq 7) = 0.0210 \quad (\text{使える}) \]
critical region は \(X \leq 7\) です。
\(0.0565\) も \(0.05\) に近い値ですが、超えているので使えません(第6節)。演習4 と同じ形です。
検算。 \(H_0\) のもとでの平均は \(20 \times 0.6 = 12\) です ✓ \(7\) は \(12\) より下で、下側の検定として正しい向きです。
8 A student is testing whether a coin is biased towards heads. She will toss it \(25\) times and test at the \(5\%\) significance level. She finds that the critical region is \(X \geq 18\), where \(X\) is the number of heads.
(a) Find the probability that \(X\) lies in the critical region when the coin is fair.
(b) Explain why this probability is not exactly \(0.05\).
日本語訳
ある生徒が、あるコインが表に偏っているかどうかを検定しています。\(25\) 回投げて、有意水準 \(5\%\) で検定します。critical region は \(X \geq 18\) であることが分かりました。\(X\) は表が出た回数です。
biased towards heads は「表に偏っている」という意味です。
(a) コインが公平なとき、\(X\) が critical region に入る確率を求めなさい。
(b) この確率がちょうど \(0.05\) にならない理由を説明しなさい。
(a) Under \(H_0\), \(X \sim B(25,\ 0.5)\). \[ P(X \geq 18) = 0.0216 \]
(b)
\(X\) can only take whole-number values, so the probability of the critical region changes in jumps as the boundary moves from one integer to the next.
There is no integer boundary that gives an area of exactly \(0.05\), so the region is chosen to be the largest one whose probability does not exceed \(0.05\).
(\(X\) は整数の値しか取れないので、境目が \(1\) つの整数から次へ動くと critical region の確率は飛び飛びに変わる。ちょうど \(0.05\) の面積を与える整数の境目は無いので、確率が \(0.05\) を超えない範囲でいちばん大きい region を選ぶ、という意味です。)
(a) \(H_0\) は「公平」なので \(p = 0.5\)、\(X \sim B(25,\ 0.5)\) です。
Binomial Cdf:   Num Trials, n: 25    Prob Success, p: 0.5
                Lower Bound: 18      Upper Bound: 25
\[ P(X \geq 18) = 0.0216 \]
検算。 \(H_0\) のもとでの平均は \(25 \times 0.5 = 12.5\) です ✓ \(18\) は \(12.5\) より上で、上側の検定として正しい向きです。
(b) これは Common errors の裏返しの問題です。「なぜ \(0.05\) ちょうどにできないのか」を、ことばで説明させています。
答えの中心は、\(X\) が整数しか取らないことです。連続な分布なら境目をいくらでも細かく動かせますが、\(X \geq 16\) と \(X \geq 17\) のあいだに区切る場所がありません。
9 A hospital records emergency admissions at a mean rate of \(6\) per hour, following a Poisson distribution. For a test at the \(5\%\) significance level of \(H_0: m = 6\) against \(H_1: m > 6\), a student proposes the critical region \(X \geq 12\).
(a) Find the probability that \(X\) lies in this region when \(H_0\) is true.
(b) Comment on the student’s choice of critical region.
日本語訳
ある病院は \(1\) 時間あたり平均 \(6\) 件の割合で救急の受け入れを記録しており、ポアソン分布にしたがいます。\(H_0: m = 6\) に対する \(H_1: m > 6\) の有意水準 \(5\%\) の検定について、ある生徒が critical region を \(X \geq 12\) と提案しました。
emergency admission は「救急の受け入れ」という意味です。
(a) \(H_0\) が正しいとき、\(X\) がこの region に入る確率を求めなさい。
(b) この生徒の critical region の選び方について論評しなさい。
(a) \[ P(X \geq 12) = 0.0201 \]
(b)
The probability \(0.0201\) does not exceed \(0.05\), so this region is allowed, but it is not the region that should be used.
\(P(X \geq 11) = 0.0426\) is also at most \(0.05\), and \(X \geq 11\) is a larger region.
The critical region should be the largest region whose probability does not exceed the significance level, so the correct critical region is \(X \geq 11\).
(確率 \(0.0201\) は \(0.05\) を超えていないのでこの region は許されるが、使うべき region ではない。\(P(X \geq 11) = 0.0426\) も \(0.05\) 以下であり、\(X \geq 11\) のほうが大きい region である。critical region は確率が有意水準を超えない範囲でいちばん大きいものにすべきなので、正しい critical region は \(X \geq 11\) である、という意味です。)
(a) \(\mathrm{Po}(6)\) で \(X \geq 12\) です。Poisson Cdf の Lower Bound に \(12\)、Upper Bound に \(100\) を入れます(GDC 第3節)。
\[ P(X \geq 12) = 0.0201 \]
(b) 「間違っている」と切り捨てないでください。\(0.05\) を超えていないので、約束は守れています。
問題は、必要以上に小さいことです。「超えない中でいちばん大きく取る」という決まりに反しています(第6節)。
答案には、\(X \geq 11\) でも \(0.05\) を超えないことを、数値で示してください。 それが「もっと大きい region が取れる」という主張の根拠になります。
\[ P(X \geq 11) = 0.0426 \leq 0.05 \]
例 4 (c) と同じ内容を、逆向きから問われています。
10 For each of the following situations, state whether a critical region should be calculated, and give a reason.
(a) A test for a population mean, where the population standard deviation is known.
(b) A test for a population mean, where the population standard deviation is unknown and is estimated from the sample.
(c) A two-tailed test for the mean of a Poisson distribution.
日本語訳
次のそれぞれの場面について、critical region を計算すべきかどうかを述べ、理由を書きなさい。
(a) 母集団の standard deviation が分かっている場合の、母平均の検定。
(b) 母集団の standard deviation が分からず、標本から推定する場合の、母平均の検定。
(c) ポアソン分布の平均についての両側検定。
(a)
Yes.
Since \(\sigma\) is known, the test uses the normal distribution, and the critical values \(1.645\), \(1.96\), \(2.326\) and \(2.576\) apply.
(b)
No.
Since \(\sigma\) is unknown, the test uses the \(t\)-distribution, and critical regions are not calculated for \(t\)-tests.
The conclusion should be reached using the \(p\)-value instead.
(c)
No.
For discrete random variables the syllabus requires critical regions only for one-tailed tests, so a two-tailed critical region for a Poisson mean would not be asked for.
この問題は計算がありません。 どの場面で何を使うかを聞いています。試験で直接こう問われることは多くありませんが、「この場面で何をすべきか」を取り違えると、大問がまるごと崩れます。
(a) \(\sigma\) 既知 → normal → critical value は \(4\) つの数のどれか(第4節)。
(b) \(\sigma\) 未知 → \(t\) → critical region は求めない(第7節)。
\(n\) が大きくても \(t\) です。 \(\sigma\) が分からなければ、標本の大きさに関係なく \(t\) を使います(AHL 4.16)。「\(n\) が \(30\) を超えたら normal」という規則は、この科目では使いません。
(c) 離散分布では片側だけです(第6節)。
表 5 に、この \(3\) つがまとめてあります。