AHL 4.18b — Tests for a mean, a proportion and \(\rho\)(平均・割合・相関の検定)
- 場面を読んで、どの検定を使うかを選べる。
- \(\sigma\) が分かっているとき
z Test、分からないときt Testを使い分けられる。 - matched pairs(対応のあるデータ)を、差をとって\(1\) 標本として扱える。
- binomial で割合の検定ができる(片側のみ)。
- Poisson で平均の検定ができる(片側のみ)。
- \(\rho = 0\)(母相関係数が \(0\) か)の検定を、電卓でできる。
- 与えられた sample variance を、電卓に入れられる形に直せる。
The idea
1. Choosing the test(検定の選び方)
AHL 4.18 の \(2\) ページめです。AHL 4.18a は判定のしかたでした。このページは「どの検定を選ぶか」と「電卓でどう動かすか」です(Type I error と Type II error は AHL 4.18c)。SL 4.11 の \(5\) つの手順(\(H_0\) と \(H_1\) → 片側か両側か → 検定の名前 → \(p\)-value → 文脈に沿って結論)は、そのまま使います。増えるのは、\(3\) 番目の検定の選択肢だけです。
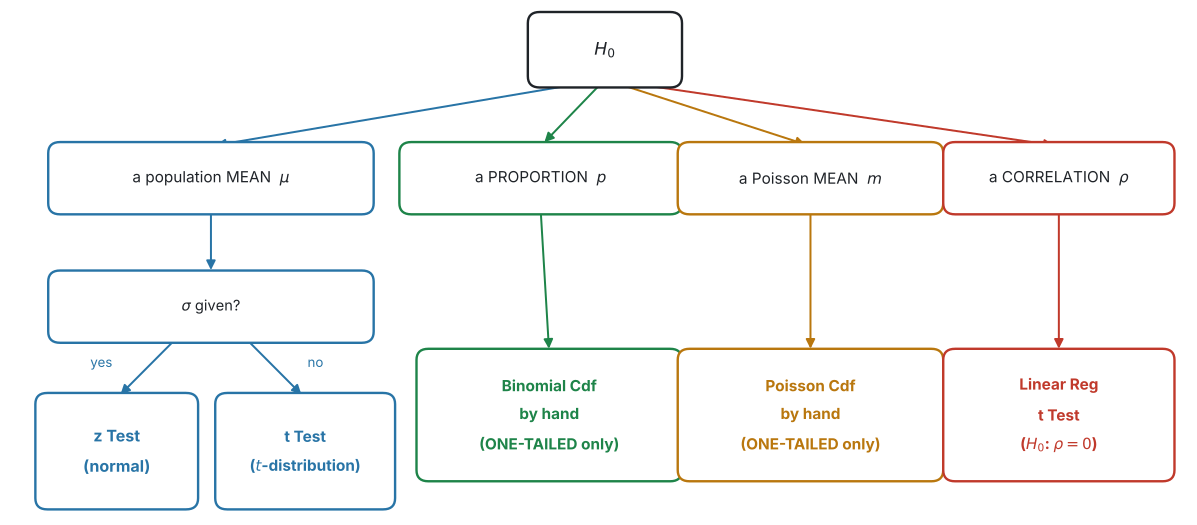
図 1 の分かれ道は、\(H_0\) が何について言っているかです。
| \(H_0\) が言っていること | 使う検定 | 電卓 |
|---|---|---|
| 正規母集団の母平均 \(\mu\)、\(\sigma\) 既知 | normal | z Test |
| 正規母集団の母平均 \(\mu\)、\(\sigma\) 未知 | \(t\) | t Test |
| 母比率(proportion)\(p\) | binomial | Binomial Cdf(手で) |
| Poisson の平均 \(m\) | Poisson | Poisson Cdf(手で) |
| 母相関係数 \(\rho = 0\) | \(t\) | Linear Reg t Test |
母平均の検定(第2節・第3節)では、\(2\) 段階で見分けます。
まず、母集団が normal distribution(正規分布)にしたがうと問題文に書いてあることを確かめます。 The mass is normally distributed with ... のような \(1\) 文です。そのうえで、\(\sigma\) が数値で書いてあれば z Test、書いていなければ t Test です。標本の大きさでは決めません(第3節)。
\(s\) や sample standard deviation が与えられても、\(\sigma\) が「与えられた」ことにはなりません(AHL 4.14)。また、母集団が正規分布と書かれていない場面は、SL 4.11 の \(\chi^2\) 検定や、第5節・第6節の binomial・Poisson の出番です。
2. Test with known \(\sigma\)(\(\sigma\) が分かっているときの z Test)
正規母集団の母平均を検定するとき、\(\sigma\) が分かっていれば normal distribution を使います。
\(\bar{X}\) の分布は、平均が \(\mu\)、standard deviation が \(\dfrac{\sigma}{\sqrt{n}}\) の正規分布です(AHL 4.15)。\(\sigma\) が分かっているなら、この分布がそのまま使えます。
検定統計量は
\[ z = \frac{\bar{x} - \mu_0}{\dfrac{\sigma}{\sqrt{n}}} \tag{1}\]
です。公式集には載っていません(公式集に 4.18 の欄はありません)。覚える必要があります。
例題 1 A machine cuts metal rods. The length of a rod is normally distributed with standard deviation \(\sigma = 0.4\) cm. The machine is set to cut rods of length \(25\) cm.
An engineer takes a random sample of \(40\) rods and finds a sample mean of \(25.15\) cm. Test, at the \(5\%\) significance level, whether the mean length has changed.
日本語訳
ある機械が金属の棒を切ります。棒の長さは standard deviation \(\sigma = 0.4\) cm の正規分布にしたがいます。機械は長さ \(25\) cm に切るよう設定されています。
rod は「棒」という意味です。
技術者が無作為に \(40\) 本を選んだところ、標本平均は \(25.15\) cm でした。平均の長さが変わったかどうかを、有意水準 \(5\%\) で検定しなさい。
まず検定を選びます。 母平均についてで、\(\sigma = 0.4\) が問題文にあります。 ですから z Test です(表 1)。
「変わったかどうか」なので two-tailed(両側)です。one-tailed(片側)ではありません。
\[ H_0: \mu = 25, \qquad H_1: \mu \neq 25 \]
\(\bar{x}\) と \(n\) が数値で与えられているので、Stats モードで入れます(GDC 第1節)。
z Test → Stats:   μ₀: 25    σ: 0.4    x̄: 25.15    n: 40
Alternate Hyp: μ ≠ μ₀z Test の結果
| 表示 | 値 |
|---|---|
z |
\(2.37\) |
PVal |
\(0.0177\) |
\(0.0177 < 0.05\) なので \(H_0\) を棄却します。
試験ではこう書く
Since \(\sigma\) is known, use a \(z\)-test.
\(H_0: \mu = 25\), \(H_1: \mu \neq 25\) (two-tailed).
\(p = 0.0177 < 0.05\), so reject \(H_0\) at the \(5\%\) significance level.
There is sufficient evidence that the mean length of the rods has changed from \(25\) cm.
(\(\sigma\) が分かっているので \(z\) 検定を使う。\(p = 0.0177 < 0.05\) なので \(5\%\) 水準で \(H_0\) を棄却する。棒の平均の長さが \(25\) cm から変わったという十分な証拠がある、という意味です。)
Alternate Hyp の欄を、必ず確認してください
両側なのに μ > μ₀ のままだと、\(p\)-value が半分の \(0.00885\) になります。
この問題では結論は変わりませんが、\(p\) が \(0.06\) 前後のときは結論が変わります。
z Test を開いたら、まず Alternate Hyp を \(H_1\) に合わせてください。
\(\sigma\) is known, so use a \(z\)-test. \[ H_0: \mu = 25, \qquad H_1: \mu \neq 25 \] Two-tailed \(z\)-test: \[ z = 2.37, \qquad p = 0.0177 \] \(0.0177 < 0.05\), so reject \(H_0\) at the \(5\%\) level. There is evidence that the mean length has changed from \(25\) cm.
3. Test with unknown \(\sigma\)(\(\sigma\) が分からないときの t Test)
\(\sigma\) が分からなければ、標本から推定した \(s\) で代用します。すると、使う分布が正規分布から \(t\) 分布に変わります(AHL 4.16)。
\[ t = \frac{\bar{x} - \mu_0}{\dfrac{s}{\sqrt{n}}}, \qquad \text{自由度} \ \nu = n - 1 \tag{2}\]
この式も公式集には載っていません。覚える必要があります。 degrees of freedom(自由度)が \(n - 1\) になる理由は AHL 4.16 にあります。
標本がどれだけ大きくても、\(\sigma\) が分からなければ \(t\) です。
日本の教科書や一般の統計の本には「\(n > 30\) なら正規分布で近似してよい」と書いてあることがあります。この科目では、その規則を使いません。
判断の基準は\(n\) ではなく \(\sigma\) です。
問題文が生のデータではなく、\(\bar{x}\)・標本の大きさ・variance(分散)だけを与えてくることがあります。このとき、与えられた分散がどちらの分散かを読み分ける必要があります。
| 問題文の言い方 | 記号 | 電卓に入れられるか |
|---|---|---|
the sample variance is 14.7 |
\(s_n^2\) | そのままでは入れられません |
the unbiased estimate of the population variance is 15.75 |
\(s_{n-1}^2\) | そのまま使えます |
t Test の sx に入れるのは \(s_{n-1}\) のほうです(AHL 4.14)。変換は
\[ s_{n-1}^2 = \frac{n}{n-1} \times s_n^2 \tag{3}\]
です。\(n = 15\) で \(s_n^2 = 14.7\) なら
\[ s_{n-1}^2 = \frac{15}{14} \times 14.7 = 15.75, \qquad s_{n-1} = \sqrt{15.75} = 3.97 \]
この \(3.97\) を sx に入れます。 \(\sqrt{14.7} = 3.83\) を入れると、\(t\) も \(p\)-value もずれます。
この式は公式集には載っていません。覚える必要があります。
例題 2 A coach claims that his athletes have a mean reaction time of \(0.25\) seconds. A researcher tests \(8\) of the athletes and records the following reaction times, in seconds.
\[ 0.28, \quad 0.31, \quad 0.24, \quad 0.33, \quad 0.29, \quad 0.27, \quad 0.35, \quad 0.26 \]
Test, at the \(5\%\) significance level, whether the mean reaction time is greater than \(0.25\) seconds.
日本語訳
あるコーチは、自分の選手たちの反応時間の平均は \(0.25\) 秒だと主張しています。ある研究者が \(8\) 人の選手を調べ、次の反応時間(秒)を記録しました。
reaction time は「反応時間」、athlete は「選手」という意味です。
平均の反応時間が \(0.25\) 秒より大きいかどうかを、有意水準 \(5\%\) で検定しなさい。
まず検定を選びます。 母平均についてですが、\(\sigma\) が問題文にありません。 データだけが与えられています。ですから t Test です。
\[ H_0: \mu = 0.25, \qquad H_1: \mu > 0.25 \]
Lists & Spreadsheet ページの列 A にデータを入れて、t Test を Data モードで実行します(GDC 第2節)。
t Test の結果
| 表示 | 値 |
|---|---|
t |
\(3.17\) |
PVal |
\(0.00786\) |
df |
\(7\) |
x̄ |
\(0.291\) |
sx |
\(0.0368\) |
n |
\(8\) |
\(0.00786 < 0.05\) なので \(H_0\) を棄却します。
試験ではこう書く
Since \(\sigma\) is unknown, use a \(t\)-test.
\(H_0: \mu = 0.25\), \(H_1: \mu > 0.25\) (one-tailed).
\(p = 0.00786 < 0.05\), so reject \(H_0\) at the \(5\%\) significance level.
There is sufficient evidence that the mean reaction time is greater than \(0.25\) seconds, so the coach’s claim is not supported.
(\(\sigma\) が分からないので \(t\) 検定を使う。\(p = 0.00786 < 0.05\) なので \(5\%\) 水準で \(H_0\) を棄却する。平均の反応時間が \(0.25\) 秒より大きいという十分な証拠があるので、コーチの主張は支持されない、という意味です。)
検算。 データの平均は \(0.291\) 秒で、\(0.25\) より大きいです ✓ \(H_1\) が上側なので、この向きは正しく、\(t\) が正の値になるのと合っています。
「\(n\) が小さいから \(t\)」ではありません。\(\sigma\) が分からないから \(t\) です(第3節)。
\(\sigma\) is unknown, so use a \(t\)-test. \[ H_0: \mu = 0.25, \qquad H_1: \mu > 0.25 \] One-tailed \(t\)-test, \(\nu = 7\): \[ t = 3.17, \qquad p = 0.00786 \] \(0.00786 < 0.05\), so reject \(H_0\) at the \(5\%\) level. There is evidence that the mean reaction time is greater than \(0.25\) seconds.
4. Matched pairs(対応のあるデータ)
matched pairs(対応のあるデータ)は、同じ人・同じ物について\(2\) 回測ったデータです。差をとって、\(1\) 標本の検定として扱います。
- 同じ生徒の、講習の前と後の点数
- 同じ患者の、投薬の前と後の血圧
- 同じ畑の、\(2\) 種類の肥料での収穫量
やることは \(1\) つ。差をとります。
\[ d = (\text{後}) - (\text{前}) \]
この \(d\) を\(1\) 本のデータ列として t Test にかけます。\(H_0\) は「差の平均は \(0\)」です。
\[ H_0: \mu_d = 0 \]
差の向きは自分で決めて、答案の最初に「\(d =\) 後 \(-\) 前 とする」と書いてください。 \((\text{前}) - (\text{後})\) でも構いませんが、\(H_1\) の向きが逆になります。「講習で点数が上がったか」なら、\(d = (\text{後}) - (\text{前})\) で \(\mu_d > 0\)、\(d = (\text{前}) - (\text{後})\) なら \(\mu_d < 0\) です。向きを書いておかないと、採点者は \(H_1\) が合っているか判断できません。
正規分布を仮定するのは、\(2\) つの母集団ではなく差のほうです。 \(1\) 標本の \(t\) 検定を使うので、\(d\) が正規分布にしたがうことを仮定します。もとの \(2\) つの母集団が正規分布かどうかは、問われません。 答案では the differences are normally distributed と書きます。the populations are normally distributed ではありません。
見分け方は \(1\) つ。「\(1\) 行目どうしを結びつける理由があるか」です。同じ人・同じ物なら結びつきますが、人数が同じだけなら、\(1\) 行目どうしに何の関係もありません。
- 同じ \(8\) 人の、講習の前と後 … matched pairs
- \(8\) 人の男子と \(8\) 人の女子 … 違う(\(2\) 標本)
- 同じ \(10\) 枚の畑の、肥料 A と肥料 B … matched pairs
- \(10\) 本の A 社の電池と \(10\) 本の B 社の電池 … 違う(\(2\) 標本)
\(2\) 標本の \(t\) 検定(2-Sample t Test、SL 4.11)は、別々の \(2\) グループを比べるものです。matched pairs でこれを使うと、ペアの情報が失われます。\(\sigma_1\) と \(\sigma_2\) の両方が与えられているときは、その正規分布版の 2-Sample z Test を使います。
例題 3 Eight students take a memory test before and after a training course. Their scores are shown below.
| Student | A | B | C | D | E | F | G | H |
|---|---|---|---|---|---|---|---|---|
| Before | \(62\) | \(58\) | \(71\) | \(55\) | \(66\) | \(60\) | \(69\) | \(57\) |
| After | \(59\) | \(57\) | \(66\) | \(54\) | \(61\) | \(58\) | \(64\) | \(56\) |
The course designer claims that the course improves memory scores. Test her claim at the \(5\%\) significance level.
日本語訳
\(8\) 人の生徒が、訓練コースの前と後に記憶力テストを受けました。得点は上の表のとおりです。
memory test は「記憶力テスト」、training course は「訓練コース」という意味です。
コースの設計者は、このコースが記憶力の得点を上げると主張しています。有意水準 \(5\%\) でこの主張を検定しなさい。
同じ生徒を \(2\) 回測っています。matched pairs です(第4節)。差をとります。
「得点が上がる」という主張を調べたいので、\(d = (\text{Before}) - (\text{After})\) とすると、主張が正しいなら \(d\) は負になるはずです。
向きを分かりやすくするため、\(d = (\text{After}) - (\text{Before})\) とします。
| Student | A | B | C | D | E | F | G | H |
|---|---|---|---|---|---|---|---|---|
| \(d\) | \(-3\) | \(-1\) | \(-5\) | \(-1\) | \(-5\) | \(-2\) | \(-5\) | \(-1\) |
\(8\) つとも負です。得点は全員下がっています。
\[ H_0: \mu_d = 0, \qquad H_1: \mu_d > 0 \]
この \(d\) を \(1\) 本のデータ列として t Test にかけると
t Test(\(d\) について)
| 表示 | 値 |
|---|---|
t |
\(-4.31\) |
PVal |
\(0.998\) |
\(0.998 > 0.05\) なので、\(H_0\) を棄却できません。
試験ではこう書く
Let \(d = (\text{after}) - (\text{before})\).
This is a matched-pairs situation, so the differences are treated as a single sample and a \(t\)-test is used.
\(H_0: \mu_d = 0\), \(H_1: \mu_d > 0\) (one-tailed).
\(p = 0.998 > 0.05\), so we do not reject \(H_0\) at the \(5\%\) significance level.
There is no evidence that the course improves memory scores.
In fact every difference is negative, so the scores went down.
(\(d\) を「後 \(-\) 前」とする。これは matched pairs の場面なので、差を \(1\) 標本として扱い \(t\) 検定を使う。\(p = 0.998 > 0.05\) なので \(5\%\) 水準で \(H_0\) を棄却しない。コースが記憶力の得点を上げるという証拠はない。実際、差はすべて負で、得点は下がっている、という意味です。)
\(p\)-value が \(0.5\) を超えて大きいときは、データが \(H_1\) と反対を向いているという合図です。
ここでは「上がる」を検定したのに、実際は全員下がっていました。\(p\) が \(1\) に近いのは、計算ミスではありません。
答案では、そのことをことばで書いてください。 「証拠がない」で止めず、「むしろ下がっている」まで書くと、読み取れていることが伝わります。
Let \(d = (\text{after}) - (\text{before})\): matched pairs, so use a one-sample \(t\)-test on the differences. \[ H_0: \mu_d = 0, \qquad H_1: \mu_d > 0 \] \[ t = -4.31, \qquad p = 0.998 \] \(0.998 > 0.05\), so do not reject \(H_0\) at the \(5\%\) level. There is no evidence that the course improves memory scores; all eight differences are negative, so the scores fell.
5. Test for a proportion(二項分布による割合の検定)
proportion(割合)が \(p_0\) から変わったか、を調べます。\(n\) 回のうち何回起きたかを数えるので、\(H_0\) のもとで
\[ X \sim B(n,\ p_0) \]
です(SL 4.8)。
電卓に、この検定はありません。 menu → Statistics → Stat Tests を開いても binomial 検定はないので(AHL 4.18a)、\(p\)-value を自分で作ります。
\[ H_1: p > p_0 \ \text{なら} \quad p\text{-value} = P(X \geq x_{\text{obs}}) \tag{4}\]
\[ H_1: p < p_0 \ \text{なら} \quad p\text{-value} = P(X \leq x_{\text{obs}}) \]
\(x_{\text{obs}}\) を含めます。 これが最大の落とし穴です(第7節)。また、binomial と Poisson の検定は、片側検定だけが出ます。\(H_1\) に \(\neq\) が出ることはなく、\(>\) か \(<\) のどちらかです。
1-Prop z Test は、別のものです
Stat Tests の \(5\) 番にある 1-Prop z Test は、正規分布で近似する検定です。名前は近いですが、ここでは近似ではなく、binomial そのものを使ってください。\(n\) が小さいと、\(2\) つの答えははっきり違います。
6. Test for a Poisson mean(ポアソン分布の平均の検定)
「一定の区間に起きる回数の平均が \(m_0\) から変わったか」を調べます。\(H_0\) のもとで
\[ X \sim \mathrm{Po}(m_0) \]
です(AHL 4.17)。やり方は binomial とまったく同じです。
\[ H_1: m > m_0 \ \text{なら} \quad p\text{-value} = P(X \geq x_{\text{obs}}) \tag{5}\]
AHL 4.17 と同じです。「\(1\) 時間に \(2.5\) 件」で \(4\) 時間ぶんを調べるなら、\(H_0\) のもとでの平均は
\[ m_0 = 2.5 \times 4 = 10 \]
です。\(2.5\) のまま計算すると、答えが桁ごと違います。
7. Including \(x_{\text{obs}}\)(\(x_{\text{obs}}\) を含めるかどうか)
binomial と Poisson の \(p\)-value では、観測した値 \(x_{\text{obs}}\) そのものを含めて確率を足します。離散分布の \(p\)-value で、いちばん間違えるところです。
\(p\)-value は「\(H_0\) が正しいとして、観測した値と同じかそれ以上に極端な値が出る確率」です。
「観測した値と同じ」を含みます。
| \(H_1\) | 正しい \(p\)-value | よくある誤り |
|---|---|---|
| \(p > p_0\)(上側) | \(P(X \geq x_{\text{obs}})\) | \(P(X > x_{\text{obs}})\) |
| \(p < p_0\)(下側) | \(P(X \leq x_{\text{obs}})\) | \(P(X < x_{\text{obs}})\) |
例 4 で、\(x_{\text{obs}} = 10\) のときの正しい \(p\)-value は \(0.0480\) です。
\(P(X > 10) = P(X \geq 11) = 0.0171\) としてしまうと、\(0.36\) 倍になります。
\(0.0480\) と \(0.0171\) では、\(2\%\) の検定で結論が分かれます。\(0.0480\) では棄却できず、\(0.0171\) では棄却してしまいます。
例題 4 In a large town, \(30\%\) of households own a dog. A researcher believes the proportion is higher in one particular neighbourhood. She surveys a random sample of \(20\) households in that neighbourhood and finds that \(10\) own a dog.
(a) State the hypotheses.
(b) Find the \(p\)-value.
(c) State the conclusion at the \(5\%\) significance level.
日本語訳
ある大きな町では、世帯の \(30\%\) が犬を飼っています。ある研究者は、特定の地区ではその割合がもっと高いと考えています。その地区で無作為に \(20\) 世帯を調べたところ、\(10\) 世帯が犬を飼っていました。
household は「世帯」、neighbourhood は「地区」という意味です。
(a) 仮説を書きなさい。
(b) \(p\)-value を求めなさい。
(c) 有意水準 \(5\%\) での結論を述べなさい。
(a) 割合についてで、「もっと高い」なので上側です。
\[ H_0: p = 0.3, \qquad H_1: p > 0.3 \]
(b) \(H_0\) のもとで \(X \sim B(20,\ 0.3)\) です。上側なので \(P(X \geq 10)\)——\(10\) を含めます(第7節)。
Binomial Cdf:   Num Trials, n: 20    Prob Success, p: 0.3
                Lower Bound: 10      Upper Bound: 20
\[ p\text{-value} = P(X \geq 10) = 0.0480 \]
(c) \(0.0480 < 0.05\) です。
試験ではこう書く
\(p = 0.0480 < 0.05\), so reject \(H_0\) at the \(5\%\) significance level.
There is sufficient evidence that the proportion of households owning a dog in this neighbourhood is greater than \(0.3\).
(\(p = 0.0480 < 0.05\) なので \(5\%\) 水準で \(H_0\) を棄却する。この地区で犬を飼っている世帯の割合が \(0.3\) より大きいという十分な証拠がある、という意味です。)
\(0.0480\) は \(0.05\) を、わずか \(0.002\) だけ下回っています。
\(P(X \geq 11) = 0.0171\) と取り違えると、\(5\%\) では結論は同じ「reject」ですが、\(2\%\) の検定なら分かれます。 \(0.0480\) では reject できず、\(0.0171\) では reject してしまいます。
Lower Bound に \(10\) を入れたか、必ず見直してください。
\(B(20,\ 0.3)\) の \(5\%\) の critical region は \(X \geq 10\) です(\(P(X \geq 10) = 0.0480 \leq 0.05\)、\(P(X \geq 9) = 0.113 > 0.05\))。
観測値 \(10\) は、ちょうどこの region のいちばん端に入っています。\(2\) つの判定が一致しています ✓
(a) \[ H_0: p = 0.3, \qquad H_1: p > 0.3 \]
(b) Under \(H_0\), \(X \sim B(20,\ 0.3)\). \[ p\text{-value} = P(X \geq 10) = 0.0480 \]
(c) \(0.0480 < 0.05\), so reject \(H_0\) at the \(5\%\) level. There is evidence that the proportion of dog-owning households in this neighbourhood is greater than \(0.3\).
例題 5 A helpline receives calls at a mean rate of \(8\) per week, following a Poisson distribution. After the helpline is advertised on local radio, \(15\) calls are received in the following week.
Test, at the \(5\%\) significance level, whether the mean rate of calls has increased.
日本語訳
ある相談電話には \(1\) 週あたり平均 \(8\) 件の割合で電話がかかり、ポアソン分布にしたがいます。地元のラジオで宣伝されたあと、次の \(1\) 週間に \(15\) 件の電話がありました。
helpline は「相談電話」、advertise は「宣伝する」という意味です。
電話の平均の割合が増えたかどうかを、有意水準 \(5\%\) で検定しなさい。
Poisson の平均についてで、「増えた」なので上側です。区間は \(1\) 週間のままなので、\(m_0\) は \(8\) のままです。
\[ H_0: m = 8, \qquad H_1: m > 8 \]
\(H_0\) のもとで \(X \sim \mathrm{Po}(8)\)。上側なので \(P(X \geq 15)\) です。
Poisson Cdf: λ: 8 Lower Bound: 15 Upper Bound: 100\[ p\text{-value} = P(X \geq 15) = 0.0173 \]
\(0.0173 < 0.05\) なので \(H_0\) を棄却します。
試験ではこう書く
Under \(H_0\), \(X \sim \mathrm{Po}(8)\), where \(X\) is the number of calls in one week.
\(H_0: m = 8\), \(H_1: m > 8\) (one-tailed).
\(p\text{-value} = P(X \geq 15) = 0.0173 < 0.05\), so reject \(H_0\) at the \(5\%\) significance level.
There is sufficient evidence that the mean rate of calls has increased.
(\(H_0\) のもとで \(X\) を \(1\) 週間の電話の件数として \(X \sim \mathrm{Po}(8)\) とする。\(p\)-value \(= P(X \geq 15) = 0.0173 < 0.05\) なので \(5\%\) 水準で \(H_0\) を棄却する。電話の平均の割合が増えたという十分な証拠がある、という意味です。)
検算。 \(H_0\) のもとでの平均は \(8\) 件で、観測は \(15\) 件でした ✓ 平均よりはっきり多いので、上側の検定で小さい \(p\)-value が出るのは正しい向きです。
Upper Bound を大きくとってください
Poisson には上限がありません。Upper Bound に \(20\) を入れると \(P(15 \leq X \leq 20)\) になってしまい、\(X > 20\) の分が抜けます。
\(\mathrm{Po}(8)\) なら \(100\) で十分です(AHL 4.18a)。
Let \(X\) be the number of calls in one week. Under \(H_0\), \(X \sim \mathrm{Po}(8)\). \[ H_0: m = 8, \qquad H_1: m > 8 \] \[ p\text{-value} = P(X \geq 15) = 0.0173 \] \(0.0173 < 0.05\), so reject \(H_0\) at the \(5\%\) level. There is evidence that the mean rate of calls has increased.
8. Test for \(\rho = 0\)(母相関係数が \(0\) かどうかの検定)
bivariate normal distribution(二変量正規分布)にしたがう \(2\) つの変数について、母相関係数が \(0\) かどうかを電卓で検定します。
SL 4.4 で、標本から \(r\) を計算しました。ここで問うのは、母集団の相関係数 \(\rho\)(ロー)が \(0\) かどうかです。\(\rho\) は population product moment correlation coefficient(母積率相関係数)といいます。
\[ H_0: \rho = 0 \]
\(H_1\) は、問題文の聞き方で決まります。
| 問題文 | \(H_1\) | 側 |
|---|---|---|
whether there is a linear correlation |
\(\rho \neq 0\) | 両側 |
whether there is a positive linear correlation |
\(\rho > 0\) | 片側 |
whether there is a negative linear correlation |
\(\rho < 0\) | 片側 |
positive や negative という語があったら片側です。電卓の Alternate Hyp も、それに合わせてください。
\(r\)(アール)は標本の相関係数でデータから計算する値、\(\rho\)(ロー)は母集団の相関係数で、知ることはできません。\(r\) が \(0\) でなくても \(\rho\) が \(0\) である可能性はあります。たまたま偏ったデータを引いただけかもしれないからです。それを確かめるのが、この検定です。
電卓には Linear Reg t Test があります。データを \(2\) 列に入れて実行するだけです(GDC 第4節)。試験では、データは必ず問題文に出ます。
\(p\)-value で判定するかわりに、\(r\) そのものを critical value と比べる形式もあります。
The critical value for \(r\) at the \(5\%\) level with \(n = 10\) is \(0.632\).
比べ方は、\(H_1\) の向きで変わります。
| \(H_1\) | 比べ方 |
|---|---|
| \(\rho \neq 0\)(両側) | \(\lvert r \rvert\) を、正の critical value と比べる |
| \(\rho > 0\)(片側・上側) | \(r\) が、正の上側 critical value を超えるか |
| \(\rho < 0\)(片側・下側) | \(r\) が、負の下側 critical value を下回るか |
絶対値を使うのは、両側のときだけです。片側で \(\lvert r \rvert\) を使うと、向きが逆のデータでも棄却してしまいます。 たとえば \(H_1: \rho > 0\) なのに \(r = -0.9\) だったら、\(\lvert r \rvert\) は大きくても棄却してはいけません。
その critical value は、必ず問題文に書いてあります。 自分で求める必要はありません(表も公式集もありません)。\(H_1\) の向きと合っているかを、必ず確かめてください。
例 6 は両側なので、\(\lvert r \rvert\) で比べます。\(\lvert 0.864 \rvert > 0.632\) なので棄却——\(p\)-value で出した結論と一致します。
例題 6 A gardener records the mass of fertiliser used, \(x\) grams, and the height of the plant after four weeks, \(y\) cm, for ten plants.
| \(x\) | \(4\) | \(7\) | \(3\) | \(9\) | \(6\) | \(5\) | \(8\) | \(4\) | \(10\) | \(7\) |
|---|---|---|---|---|---|---|---|---|---|---|
| \(y\) | \(22\) | \(26\) | \(19\) | \(31\) | \(23\) | \(27\) | \(25\) | \(20\) | \(30\) | \(24\) |
Assume that \(x\) and \(y\) follow a bivariate normal distribution. Test, at the \(1\%\) significance level, whether there is a linear correlation between the mass of fertiliser and the height of the plant.
日本語訳
ある庭師が、\(10\) 本の植物について、使った肥料の重さ \(x\) グラムと、\(4\) 週間後の植物の高さ \(y\) cm を記録しました。
fertiliser は「肥料」という意味です。
\(x\) と \(y\) は bivariate normal distribution(二変量正規分布)にしたがうものとします。肥料の重さと植物の高さのあいだに線形の相関があるかどうかを、有意水準 \(1\%\) で検定しなさい。
母相関係数についての検定です。「相関があるかどうか」で向きの指定がないので両側です。
\[ H_0: \rho = 0, \qquad H_1: \rho \neq 0 \]
Lists & Spreadsheet ページの列 A に \(x\)、列 B に \(y\) を入れて、Linear Reg t Test を実行します(GDC 第4節)。
Linear Reg t Test の結果
| 表示 | 値 |
|---|---|
r |
\(0.864\) |
t |
\(4.85\) |
PVal |
\(0.00128\) |
df |
\(8\) |
\(0.00128 < 0.01\) なので \(H_0\) を棄却します。
試験ではこう書く
\(H_0: \rho = 0\), \(H_1: \rho \neq 0\) (two-tailed).
\(r = 0.864\), \(p = 0.00128 < 0.01\), so reject \(H_0\) at the \(1\%\) significance level.
There is sufficient evidence of a linear correlation between the mass of fertiliser used and the height of the plant.
(\(p = 0.00128 < 0.01\) なので \(1\%\) 水準で \(H_0\) を棄却する。使った肥料の重さと植物の高さのあいだに線形の相関があるという十分な証拠がある、という意味です。)
相関があるという結論は、因果関係の結論ではありません(SL 4.4)。
たとえば、庭師が元気そうな苗にたくさん肥料をやっていたのかもしれません。
答案には there is evidence of a linear correlation と書きます。the fertiliser causes the plants to grow taller とは書きません。
\[ H_0: \rho = 0, \qquad H_1: \rho \neq 0 \] Linear Reg \(t\)-test, \(\nu = 8\): \[ r = 0.864, \qquad t = 4.85, \qquad p = 0.00128 \] \(0.00128 < 0.01\), so reject \(H_0\) at the \(1\%\) level. There is evidence of a linear correlation between the mass of fertiliser and the height of the plant.
Why it works
なぜ binomial と Poisson だけ、手で作るのか
z Test も t Test も、電卓が \(p\)-value を出してくれます。なぜ binomial と Poisson だけ違うのでしょうか。
\(p\)-value の定義に戻ると、理由が見えます。
\(p\)-value は「\(H_0\) が正しいとして、観測値と同じかそれ以上に極端な値が出る確率」です。
- 連続な分布(normal、\(t\))… 「それ以上に極端」は面積です。面積を出すには積分が要るので、電卓の出番になります。
- 離散な分布(binomial、Poisson)… 「それ以上に極端」は、確率を足すだけです。
\[ P(X \geq 10) = P(X = 10) + P(X = 11) + \cdots + P(X = 20) \]
そして、この足し算をやってくれるコマンドはすでにあります。 Binomial Cdf と Poisson Cdf です。
専用の検定コマンドが要らない、というのが本当のところです。Cdf に範囲を入れれば、それがそのまま \(p\)-value です。
なぜ \(x_{\text{obs}}\) を含めるのか
\(p\)-value の定義に「観測値と同じかそれ以上に極端」とあります。「同じ」が入っています。
観測した \(x_{\text{obs}}\) そのものも、「これくらい極端なことが起きる確率」の一部です。
連続な分布では \(P(X = a) = 0\) なので、含めても含めなくても同じでした。離散では \(P(X = a) \neq 0\) なので、はっきり差が出ます。
例 4 では \(P(X = 10) = 0.0308\) です。含めるか含めないかで、これだけ変わります。
Common errors
t Test を使う
問題文に \(\sigma\) の数値があれば z Test です(第1節)。
t Test にはそもそも \(\sigma\) を入れる欄がありません。入れる欄がないことに気づいたら、選んだ検定が違います。
標本の大きさには関係ありません(第3節)。判断は \(\sigma\) でします。
ペアになる理由(同じ人・同じ物)があるかどうかで決めます(第4節)。個数が同じでも、ペアでないことがあります。
positive / negative を見落として両側にする
positive linear correlation なら \(H_1: \rho > 0\) の片側です(第8節)。\(p\)-value が \(2\) 倍になってしまいます。
2-Sample t Test を使う
差をとって\(1\) 標本にします(第4節)。matched pairs は \(1\) 標本の検定として扱います。
\(d =\) 後 \(-\) 前 なのか、前 \(-\) 後 なのかで、\(H_1\) の向きが逆になります。答案の最初に宣言してください(第4節)。
1-Prop z Test を使う
割合の検定は binomial distribution そのものを使います。近似ではありません(第5節)。
Poisson Cdf の Upper Bound を小さくとる
Poisson には上限がありません。\(m\) よりずっと大きい数を入れてください(例 5)。
Alternate Hyp を両側のままにする/片側のままにする
\(p\)-value が \(2\) 倍または半分になります。z Test と t Test を開いたら、まずこの欄を見てください(例 1)。
there is evidence of a linear correlation までです。causes とは書きません(例 6)。
binomial と Poisson の検定は、片側だけです(第5節)。
\(H_0\) を reject と書いただけで止めると、点が付かないことがあります。「何についての証拠なのか」を書いてください(SL 4.11)。
Using your GDC (TI-Nspire CX II)
連続な分布の検定は、ここから始まります。
menu → Statistics → Stat Tests一覧は z Test、t Test、2-Sample z Test、2-Sample t Test、1-Prop z Test、2-Prop z Test、χ² GOF、χ² 2-way Test、2-Sample F Test、Linear Reg t Test …と続きます。
このページで使うのは、\(1\) 番、\(2\) 番、そして Linear Reg t Test の \(3\) つだけです。
binomial と Poisson の検定は、ここにはありません(第5節)。次の節を見てください。
Binomial and Poisson tests(Distributions から使う)
menu → Statistics → Distributions → Binomial Cdf
                                  → Poisson Cdf
Stat Tests には binomial 検定も Poisson 検定もないので、\(p\)-value はこの \(2\) つで自分で作ります(AHL 4.18a)。
Cdf で \(p\)-value を作る
| 欄 | 入れるもの |
|---|---|
Num Trials, n / λ |
\(H_0\) の \(n\) と \(p_0\)、または \(m_0\) |
Lower Bound |
上側なら \(x_{\text{obs}}\)、下側なら \(0\) |
Upper Bound |
上側なら \(n\)(Poisson は \(100\) など)、下側なら \(x_{\text{obs}}\) |
\(x_{\text{obs}}\) を含める向きに注意してください(第7節)。
z Test(\(\sigma\) が分かっているとき)
menu → Statistics → Stat Tests → z Test最初に Data Input Method で Data か Stats かを聞かれます。
Data と Stats
| 選ぶもの | いつ |
|---|---|
Stats |
\(\bar{x}\) と \(n\) が数値で与えられているとき |
Data |
データの列が与えられているとき |
Stats を選んだときの欄です。
z Test の入力欄
| 欄 | 入れるもの |
|---|---|
μ₀ |
\(H_0\) の平均 |
σ |
母集団の standard deviation |
x̄ |
標本平均 |
n |
標本の大きさ |
Alternate Hyp |
\(H_1\)(≠/</> から選ぶ) |
t Test(\(\sigma\) が分からないとき)
menu → Statistics → Stat Tests → t Test\(\sigma\) を入れる欄がありません。 これが z Test との見た目の違いです。
Stats を選んだときの欄です。
t Test の入力欄(Stats)
| 欄 | 入れるもの |
|---|---|
μ₀ |
\(H_0\) の平均 |
x̄ |
標本平均 |
sx |
標本から計算した standard deviation(\(s\)) |
n |
標本の大きさ |
Alternate Hyp |
\(H_1\) |
データが列で与えられているときは Data を選び、List の欄に列の名前(a[] など)を入れます。
Lists & Spreadsheet ページで、列 A のいちばん上のグレーの行に time などと打っておくと、List の欄で var キーから選べます(SL 4.11)。
名前を付けないと a[] のままですが、それでも動きます。
Matched pairs(対応のあるデータのとき)
電卓に Paired t Test はありません。 差の列を自分で作ります。
- 列 A に Before、列 B に After を入れる
- 列 C のグレーの行の \(1\) つ下(式の行)に
=b[]-a[]と入力する - 列 C に差が並ぶので、
t TestのDataモードで列 C を使う
Lists & Spreadsheet の各列には、名前の行(グレー)のすぐ下に式の行があります。ここに =b[]-a[] と入れると、列全体が自動で計算されます。
データの \(1\) 行目に入れると、\(1\) つの数しか出ません。
Linear Reg t Test(\(\rho = 0\) の検定)
menu → Statistics → Stat Tests → Linear Reg t TestLinear Reg t Test の入力欄
| 欄 | 入れるもの |
|---|---|
X List |
\(x\) の列 |
Y List |
\(y\) の列 |
Alternate Hyp |
\(H_1\)(ふつうは ≠ 0) |
結果には t、PVal、df、r、r²、a、b が出ます。必要なのは r と PVal です。
a と b は回帰直線です
Linear Reg t Test は、検定と同時に regression line(回帰直線) \(y = a + bx\) も出します。
IB の記法とは、\(a\) と \(b\) が逆です。IB では \(y = ax + b\) と書くので、電卓の b が IB の \(a\)(gradient(傾き))、電卓の a が IB の \(b\)(intercept(切片))にあたります。
この項目では回帰直線は聞かれないことが多いのですが、\(1\) つの問題で両方問われることがあります。そのときだけ注意してください。
Exercises
1 For each of the following situations, state which test should be used.
(a) Testing whether the mean mass of a population of birds is \(32\) g, given a sample of \(12\) birds and told that the population standard deviation is \(4\) g.
(b) Testing whether the mean mass of a population of birds is \(32\) g, given the masses of a sample of \(50\) birds and no other information.
(c) Testing whether the proportion of faulty items produced by a machine has risen above \(0.05\).
(d) Testing whether the blood pressure of a group of patients has changed after treatment, given each patient’s reading before and after.
日本語訳
次のそれぞれの場面について、どの検定を使うべきかを述べなさい。
(a) ある鳥の母集団の平均の重さが \(32\) g かどうかの検定。\(12\) 羽の標本が与えられ、母集団の standard deviation は \(4\) g と教えられている。
(b) ある鳥の母集団の平均の重さが \(32\) g かどうかの検定。\(50\) 羽の標本の重さが与えられ、ほかの情報はない。
(c) ある機械が作る不良品の割合が \(0.05\) より上がったかどうかの検定。
(d) ある患者たちの血圧が治療のあとで変わったかどうかの検定。各患者の治療前と治療後の値が与えられている。
(a)
A \(z\)-test, because \(\sigma\) is known.
(b)
A \(t\)-test, because \(\sigma\) is unknown.
(c)
A binomial test, one-tailed, because the hypothesis is about a proportion.
(d)
A matched-pairs \(t\)-test: take the differences and treat them as a single sample.
2 The time taken to complete a task is normally distributed with standard deviation \(\sigma = 15\) seconds. A training programme claims to change the mean time from \(180\) seconds. A random sample of \(50\) workers has a mean time of \(184.2\) seconds.
Test, at the \(5\%\) significance level, whether the mean time is greater than \(180\) seconds.
日本語訳
ある作業にかかる時間は standard deviation \(\sigma = 15\) 秒の正規分布にしたがいます。ある訓練プログラムは、平均時間を \(180\) 秒から変えると主張しています。無作為に選んだ \(50\) 人の作業者の平均時間は \(184.2\) 秒でした。
平均時間が \(180\) 秒より大きいかどうかを、有意水準 \(5\%\) で検定しなさい。
\(\sigma\) is known, so use a \(z\)-test. \[ H_0: \mu = 180, \qquad H_1: \mu > 180 \] One-tailed \(z\)-test: \[ z = 1.98, \qquad p = 0.0239 \] \(0.0239 < 0.05\), so reject \(H_0\) at the \(5\%\) level. There is evidence that the mean time is greater than \(180\) seconds.
\(\sigma = 15\) が与えられているので z Test です。
z Test → Stats:   μ₀: 180   σ: 15   x̄: 184.2   n: 50
                  Alternate Hyp: μ > μ₀
\[ z = 1.98, \qquad p = 0.0239 \]
Alternate Hyp を μ > μ₀ にしてください。 μ ≠ μ₀ のままだと \(p = 0.0477\) になります。
この問題では、どちらでも \(0.05\) を下回るので結論は同じです。しかし片側と両側では答えの数値が違うので、書いた \(p\) が間違いになります。
検算。 standard error は \(\dfrac{15}{\sqrt{50}} = 2.12\) で、\(184.2 - 180 = 4.2\) はその約 \(2\) 倍です ✓ \(z \approx 1.98\) と合っています。
3 A bakery claims that its loaves have a mean mass of \(505\) grams. A consumer measures the masses of ten loaves, in grams:
\[ 512, \quad 505, \quad 498, \quad 517, \quad 509, \quad 503, \quad 515, \quad 508, \quad 511, \quad 502 \]
Test, at the \(5\%\) significance level, whether the mean mass differs from \(505\) grams.
日本語訳
あるパン屋は、自分のところのパンの平均の重さは \(505\) グラムだと主張しています。ある消費者が \(10\) 個のパンの重さ(グラム)を測りました。
loaf(複数形 loaves)は「パン \(1\) 斤」という意味です。
平均の重さが \(505\) グラムと異なるかどうかを、有意水準 \(5\%\) で検定しなさい。
\(\sigma\) is unknown, so use a \(t\)-test. \[ H_0: \mu = 505, \qquad H_1: \mu \neq 505 \] Two-tailed \(t\)-test, \(\nu = 9\): \[ t = 1.58, \qquad p = 0.149 \] \(0.149 > 0.05\), so do not reject \(H_0\) at the \(5\%\) level. There is insufficient evidence that the mean mass differs from \(505\) grams.
データだけが与えられていて \(\sigma\) がないので、t Test です。
列 A にデータを入れ、Data モードで実行します。
\[ \bar{x} = 508, \qquad s = 6.02, \qquad t = 1.58, \qquad p = 0.149 \]
「異なるか」なので両側です。Alternate Hyp を μ ≠ μ₀ にします。
\(0.149\) は \(0.05\) よりずっと大きいので、棄却できません。
accept とは書きません
「平均が \(505\) g だと分かった」ではありません。「\(505\) g と違うと言えるだけの証拠がなかった」だけです(SL 4.11)。
標本平均は \(508\) g で、\(505\) g より \(3\) g 大きいのです。それでも「違う」と言い切れるほどの差ではなかった、というのがこの結論の意味です。
検算。 標本平均 \(508\) は \(505\) より大きいので、\(t\) が正なのは正しい向きです ✓
4 Seven students take a spelling test before and after a week of practice. Their scores out of \(40\) are shown.
| Student | A | B | C | D | E | F | G |
|---|---|---|---|---|---|---|---|
| Before | \(24\) | \(31\) | \(28\) | \(35\) | \(22\) | \(30\) | \(27\) |
| After | \(27\) | \(33\) | \(29\) | \(38\) | \(26\) | \(31\) | \(30\) |
Test, at the \(1\%\) significance level, whether the week of practice improves scores.
日本語訳
\(7\) 人の生徒が、\(1\) 週間の練習の前と後につづりのテストを受けました。\(40\) 点満点の得点は上の表のとおりです。
spelling test は「つづりのテスト」という意味です。
\(1\) 週間の練習が得点を上げるかどうかを、有意水準 \(1\%\) で検定しなさい。
Let \(d = (\text{after}) - (\text{before})\): matched pairs, so use a one-sample \(t\)-test on the differences. \[ H_0: \mu_d = 0, \qquad H_1: \mu_d > 0 \] One-tailed \(t\)-test, \(\nu = 6\): \[ t = 5.67, \qquad p = 0.000650 \] \(0.000650 < 0.01\), so reject \(H_0\) at the \(1\%\) level. There is evidence that the week of practice improves scores.
同じ生徒の前と後なので matched pairs です。差をとります。
\[ d = 3, \ 2, \ 1, \ 3, \ 4, \ 1, \ 3 \]
\(7\) つとも正です。\(d =\) 後 \(-\) 前 と決めたので、「上がる」は \(\mu_d > 0\) です。
列 C に =b[]-a[] を入れて差を作り、t Test の Data モードで列 C を使います(GDC 第3節)。
\[ \bar{d} = 2.43, \qquad s_d = 1.13, \qquad t = 5.67, \qquad p = 0.000650 \]
\(1\%\) の検定なので、比べる相手は \(0.01\) です。\(0.000650\) はそれよりずっと小さいので棄却します。
検算。 差が \(7\) つとも正なので、\(t\) が正で \(p\) が小さいのは正しい向きです ✓
例 3 と見くらべてください。あちらは差が全部負で \(p = 0.998\) でした。同じ手順で、向きだけが逆です。
5 A factory claims that \(15\%\) of its output needs reworking. A manager suspects the true proportion is higher and inspects a random sample of \(40\) items, finding that \(10\) need reworking.
Test the manager’s suspicion at the \(5\%\) significance level.
日本語訳
ある工場は、生産物の \(15\%\) が手直しを必要とすると主張しています。ある管理者は実際の割合はもっと高いと疑い、無作為に \(40\) 個を検査したところ、\(10\) 個が手直しを必要としました。
output は「生産物」、rework は「手直しする」という意味です。
管理者の疑いを、有意水準 \(5\%\) で検定しなさい。
\[ H_0: p = 0.15, \qquad H_1: p > 0.15 \] Under \(H_0\), \(X \sim B(40,\ 0.15)\). \[ p\text{-value} = P(X \geq 10) = 0.0672 \] \(0.0672 > 0.05\), so do not reject \(H_0\) at the \(5\%\) level. There is insufficient evidence that the proportion needing reworking is greater than \(0.15\).
割合の検定なので binomial です。1-Prop z Test ではありません(第5節)。
Binomial Cdf:   Num Trials, n: 40    Prob Success, p: 0.15
                Lower Bound: 10      Upper Bound: 40
\[ P(X \geq 10) = 0.0672 \]
\(10\) を含めます(第7節)。\(P(X \geq 11) = 0.0299\) としてしまうと、\(0.05\) を下回るので結論が逆になります。
\(0.0672 > 0.05\) なので棄却できません。
検算。 \(H_0\) のもとでの平均は \(40 \times 0.15 = 6\) 個です。観測は \(10\) 個で、たしかに多いのですが、\(5\%\) の基準を満たすほどではなかったということです ✓
6 A shop receives returns at a mean rate of \(3.5\) per day, following a Poisson distribution. After a change to the return policy, only \(1\) return is received on a particular day.
Test, at the \(5\%\) significance level, whether the mean rate of returns has decreased.
日本語訳
ある店には \(1\) 日あたり平均 \(3.5\) 件の割合で返品があり、ポアソン分布にしたがいます。返品の規則を変えたあと、ある \(1\) 日の返品は \(1\) 件だけでした。
return は「返品」、return policy は「返品の規則」という意味です。
返品の平均の割合が減ったかどうかを、有意水準 \(5\%\) で検定しなさい。
\[ H_0: m = 3.5, \qquad H_1: m < 3.5 \] Under \(H_0\), \(X \sim \mathrm{Po}(3.5)\). \[ p\text{-value} = P(X \leq 1) = 0.136 \] \(0.136 > 0.05\), so do not reject \(H_0\) at the \(5\%\) level. There is insufficient evidence that the mean rate of returns has decreased.
これは下側の検定です。 「減った」なので \(H_1\): \(m < 3.5\)。
下側の \(p\)-value は \(P(X \leq x_{\text{obs}})\) です。\(x_{\text{obs}} = 1\) を含めます(第7節)。
Poisson Cdf: λ: 3.5 Lower Bound: 0 Upper Bound: 1\[ P(X \leq 1) = 0.136 \]
下側では Lower Bound が \(0\) です。 上側と逆になります。
\(0.136 > 0.05\) なので棄却できません。
\(\mathrm{Po}(3.5)\) で \(X = 0\) でも \(P(X \leq 0) = 0.0302\) で、やっと \(0.05\) を下回ります。
\(1\) 日だけ見ても、判断できることは限られています。 もし \(1\) 週間ぶんを見るなら \(m_0 = 3.5 \times 7 = 24.5\) になり、はるかに細かい判定ができます(第6節)。
7 A biologist records the width, \(x\) cm, and the mass, \(y\) g, of eight shells.
| \(x\) | \(1\) | \(2\) | \(3\) | \(4\) | \(5\) | \(6\) | \(7\) | \(8\) |
|---|---|---|---|---|---|---|---|---|
| \(y\) | \(12\) | \(15\) | \(13\) | \(18\) | \(16\) | \(20\) | \(17\) | \(22\) |
Assume the variables follow a bivariate normal distribution. Test, at the \(5\%\) significance level, whether there is a linear correlation between width and mass.
日本語訳
ある生物学者が、\(8\) 個の貝殻について幅 \(x\) cm と重さ \(y\) g を記録しました。
shell は「貝殻」という意味です。
これらの変数は二変量正規分布にしたがうものとします。幅と重さのあいだに線形の相関があるかどうかを、有意水準 \(5\%\) で検定しなさい。
\[ H_0: \rho = 0, \qquad H_1: \rho \neq 0 \] Linear Reg \(t\)-test, \(\nu = 6\): \[ r = 0.855, \qquad t = 4.03, \qquad p = 0.00687 \] \(0.00687 < 0.05\), so reject \(H_0\) at the \(5\%\) level. There is evidence of a linear correlation between the width and the mass of the shells.
列 A に \(x\)、列 B に \(y\) を入れて Linear Reg t Test です(GDC 第4節)。
\[ r = 0.855, \qquad p = 0.00687 \]
自由度は \(\nu = n - 2 = 6\) です。\(n - 1\) ではありません。 \(2\) つ引くのは、回帰直線に \(2\) つの数(傾きと切片)を使うからです。
「相関があるかどうか」なので両側。Alternate Hyp は ≠ 0 です。
\(r = 0.855\) は大きい値ですが、「大きいから相関がある」とは言えません。 \(n\) が小さければ、偶然でもこれくらいの \(r\) は出ます。
\(p\)-value が「偶然でこれくらいになる確率」を教えてくれます。判定は \(p\) でします。
8 A student is testing \(H_0: p = 0.25\) against \(H_1: p > 0.25\) using a sample of \(30\). She observes \(12\) successes and calculates the \(p\)-value as \(P(X > 12) = 0.0216\).
(a) Explain why her \(p\)-value is incorrect.
(b) Find the correct \(p\)-value.
日本語訳
ある生徒が、大きさ \(30\) の標本を使って \(H_0: p = 0.25\) を \(H_1: p > 0.25\) に対して検定しています。成功が \(12\) 回観測され、\(p\)-value を \(P(X > 12) = 0.0216\) と計算しました。
(a) この \(p\)-value がなぜ正しくないかを説明しなさい。
(b) 正しい \(p\)-value を求めなさい。
(a)
The \(p\)-value is the probability of a result at least as extreme as the one observed, and this includes the observed value itself.
She has used \(P(X > 12)\), which excludes \(X = 12\), so she should have used \(P(X \geq 12)\).
(\(p\)-value は、観測した結果と同じかそれ以上に極端な結果が出る確率であり、これには観測値そのものが含まれる。彼女は \(X = 12\) を除く \(P(X > 12)\) を使っているので、\(P(X \geq 12)\) を使うべきだった、という意味です。)
(b) Under \(H_0\), \(X \sim B(30,\ 0.25)\). \[ p\text{-value} = P(X \geq 12) = 0.0507 \]
この \(1\) つのずれで、結論が変わります。
| \(p\)-value | \(5\%\) での判定 |
|---|---|
| 誤り \(0.0216\) | reject |
| 正しい \(0.0507\) | do not reject |
\(0.0507\) は \(0.05\) をわずかに超えています。 正しく計算すると、棄却できません。
抜けていたのは \(P(X = 12) = 0.0291\) の \(1\) 本です。これが \(0.0216\) に足されて \(0.0507\) になります。
検算。 \(0.0216 + 0.0291 = 0.0507\) ✓
この設定は AHL 4.18a の演習4 と同じ \(B(30,\ 0.25)\) です。あちらでは critical region が \(X \geq 13\) でした。観測値 \(12\) は critical region に入っていません ✓ \(2\) つの判定が一致しています。
9 Customers arrive at a help desk at a mean rate of \(2.5\) per hour, following a Poisson distribution. On one afternoon, \(18\) customers arrive during a four-hour period. The supervisor wishes to test whether the mean rate has increased.
(a) State the value of \(m\) under \(H_0\) for this four-hour period.
(b) Find the \(p\)-value and state the conclusion at the \(5\%\) significance level.
日本語訳
ある案内窓口には \(1\) 時間あたり平均 \(2.5\) 人の割合で客が来て、ポアソン分布にしたがいます。ある午後、\(4\) 時間のあいだに \(18\) 人の客が来ました。管理者は平均の割合が増えたかどうかを検定したいと考えています。
help desk は「案内窓口」、supervisor は「管理者」という意味です。
(a) この \(4\) 時間について、\(H_0\) のもとでの \(m\) の値を述べなさい。
(b) \(p\)-value を求め、有意水準 \(5\%\) での結論を述べなさい。
(a) \[ m = 2.5 \times 4 = 10 \]
(b) Let \(X\) be the number of customers in a four-hour period. Under \(H_0\), \(X \sim \mathrm{Po}(10)\). \[ H_0: m = 10, \qquad H_1: m > 10 \] \[ p\text{-value} = P(X \geq 18) = 0.0143 \] \(0.0143 < 0.05\), so reject \(H_0\) at the \(5\%\) level. There is evidence that the mean rate of arrivals has increased.
(a) 割合は「\(1\) 時間あたり \(2.5\) 人」ですが、観測したのは\(4\) 時間ぶんです。\(m\) は区間の長さに比例します(AHL 4.17)。
\[ m = 2.5 \times 4 = 10 \]
(b) \(H_0\) のもとで \(X \sim \mathrm{Po}(10)\) です。上側なので \(P(X \geq 18)\)——\(18\) を含めます(第7節)。
Poisson Cdf: λ: 10 Lower Bound: 18 Upper Bound: 100\[ P(X \geq 18) = 0.0143 \]
\(P(X \geq 18)\) を \(\mathrm{Po}(2.5)\) で計算すると \(2.15 \times 10^{-10}\) になります。
「\(p\) がとても小さい」ではなく、「区間を合わせ忘れた」という合図です。答えが \(10^{-6}\) より小さくなったら、\(m\) を作り直したか確かめてください。
検算。 \(H_0\) のもとでの平均は \(10\) 人、観測は \(18\) 人です ✓ 平均よりはっきり多く、上側の検定で小さい \(p\)-value が出るのは正しい向きです。
10 A student writes the following in an examination.
“The sample size is \(60\), which is greater than \(30\), so I will use a \(z\)-test even though \(\sigma\) is not given.”
(a) Explain why this reasoning is not correct for this course.
(b) State which test should be used, and give a reason.
日本語訳
ある生徒が、試験で次のように書きました。
「標本の大きさは \(60\) で \(30\) より大きいので、\(\sigma\) が与えられていなくても \(z\) 検定を使う。」
(a) この理由づけが、この科目では正しくない理由を説明しなさい。
(b) どの検定を使うべきかを述べ、理由を書きなさい。
(a)
The \(t\)-distribution is used when \(\sigma\) is unknown, regardless of sample size.
The choice of test depends on whether \(\sigma\) is known, not on how large the sample is, so the size of \(60\) is not a reason to use a \(z\)-test.
(\(\sigma\) が分からないときは、標本の大きさに関係なく \(t\) 分布を使う。検定の選択は \(\sigma\) が分かっているかどうかで決まり、標本がどれだけ大きいかでは決まらないので、\(60\) という大きさは \(z\) 検定を使う理由にならない、という意味です。)
(b)
A \(t\)-test should be used, because \(\sigma\) is unknown and must be estimated from the sample.
(\(\sigma\) が分からず標本から推定しなければならないので、\(t\) 検定を使うべきだ、という意味です。)
この生徒の言っていることは、一般の統計では間違いではありません。 \(n\) が大きいと \(t\) 分布は正規分布にとても近づくので、実務では正規分布で近似することがあります。
しかし、この科目では、\(\sigma\) が分からなければ標本の大きさに関係なく \(t\) を使うと決まっています(第3節)。試験では、この規則で採点されます。
「一般には正しいが、この科目では使わない」——そういう規則がいくつかあります。AHL 4.16 の confidence interval(信頼区間)でも、まったく同じ規則が使われています。
判断の基準は \(\sigma\) だけ、と覚えてください。\(n\) は関係ありません。